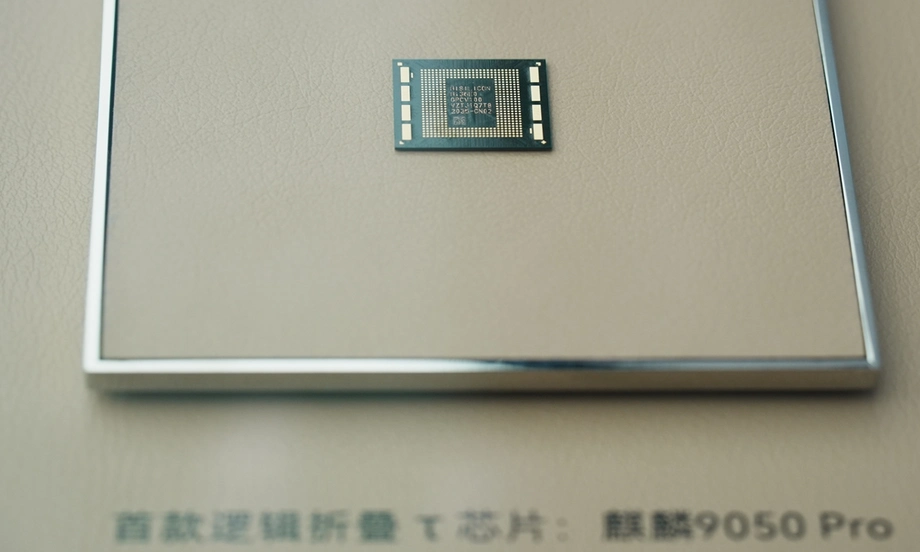
หัวเว่ยนำกลยุทธ์ชิปสามมิติมาใช้ในโทรศัพท์
หัวเว่ยระบุว่า Kirin 9050 series นำเทคโนโลยี LogicFolding เข้าสู่การผลิตจำนวนมากแล้ว โดยเพิ่มความหนาแน่นของทรานซิสเตอร์ 53.5% ด้วยการจัดวางวงจรประมวลผลไว้บนชั้นที่เชื่อมต่อถึงกัน ในการบรรยายสรุปที่ศูนย์วิจัยเหลียนชิวหูในเซี่ยงไฮ้ เมื่อวันที่ 13 ตุลาคม 2026 บริษัทอธิบายวิธีเพิ่มประสิทธิภาพชิปด้วยการย่นระยะทางที่สัญญาณไฟฟ้าเดินทางภายในชิป
สารบัญ
- หัวเว่ยนำกลยุทธ์ชิปสามมิติมาใช้ในโทรศัพท์
- LogicFolding ย่นระยะทางได้อย่างไร
- ตัวเลขประสิทธิภาพหมายถึงอะไร
- จุดเชื่อมต่อนับล้านเชื่อมชั้นต่าง ๆ เข้าด้วยกัน
- โมเดล AI ใช้หน่วยความจำน้อยลง
- จากการประกาศเดือนพฤษภาคมสู่การเปิดเผยข้อมูลเดือนตุลาคม
- ทางเลี่ยงข้อจำกัดด้านอุปกรณ์ที่มาพร้อมต้นทุน
- เป้าหมายของหัวเว่ยสำหรับปี 2027 และ 2031
- เหตุใดความทะเยอทะยานจึงครอบคลุมมากกว่าสมาร์ตโฟน
- ประเด็นสำคัญ
หัวเว่ยรายงานว่าประสิทธิภาพ CPU เพิ่มขึ้น 23% เมื่อทำงานร่วมกันหลายคอร์ ประสิทธิภาพการเรนเดอร์กราฟิกเพิ่มขึ้น 40% และกำลังประมวลผลปัญญาประดิษฐ์เพิ่มขึ้น 140% เมื่อเทียบกับรุ่นก่อนหน้า ส่วน Kirin 9050 Pro ซึ่งเป็นรุ่นสเปกสูงกว่า มีจำนวนทรานซิสเตอร์ที่รายงานอยู่ที่ 238 ล้านตัวต่อตารางมิลลิเมตร
สวี ซงอวี่ หัวหน้าฝ่ายบริหารผลิตภัณฑ์ชิปสำหรับอุปกรณ์ปลายทางไร้สายในธุรกิจเซมิคอนดักเตอร์ของหัวเว่ย กล่าวว่า ชิปซีรีส์นี้มีจุดเชื่อมต่อแบบไฮบริดมากกว่า 50 ล้านจุด และจุดเชื่อมต่อสัญญาณที่ใช้งานได้จริงมากกว่า 5 ล้านจุด การเชื่อมต่อเหล่านี้ทำให้วงจรบนชั้นต่าง ๆ สื่อสารกันผ่านเส้นทางแนวตั้งระยะสั้น แทนการพึ่งพาเส้นทางที่ยาวกว่าบนพื้นผิวระนาบ
การพัฒนานี้มีความสำคัญ เพราะข้อจำกัดต่าง ๆ ปิดกั้นไม่ให้หัวเว่ยเข้าถึงอุปกรณ์ผลิตชิปที่ล้ำหน้าที่สุดบางชนิดของโลก บริษัทกำลังพัฒนาประสิทธิภาพผ่านการจัดวางวงจร การเชื่อมต่อ และการออกแบบที่ประสานกัน ขณะที่ยังเผชิญข้อจำกัดด้านเทคโนโลยีการผลิต
บริษัทระบุว่า Mate 90 Pro Max เป็นอุปกรณ์ทดสอบ และใช้ Mate 80 Pro Max เป็นเครื่องเปรียบเทียบ ตัวเลขของหัวเว่ยเป็นผลจากการวัดของบริษัทเอง ผู้ซื้อยังต้องอาศัยการทดสอบอิสระเพื่อประเมินอายุแบตเตอรี่ ประสิทธิภาพการเล่นเกมต่อเนื่อง และการตอบสนองของ AI ในแอปพลิเคชันที่ใช้ในชีวิตประจำวัน
LogicFolding ย่นระยะทางได้อย่างไร
ทรานซิสเตอร์คือสวิตช์อิเล็กทรอนิกส์ขนาดเล็ก สวิตช์เหล่านี้นับพันล้านตัวรวมกันเป็นวงจรที่ใช้เรียกใช้ซอฟต์แวร์ วาดกราฟิก และประมวลผลข้อมูล ความเร็วส่วนหนึ่งขึ้นอยู่กับว่าสัญญาณเคลื่อนที่ระหว่างกันได้รวดเร็วเพียงใด
การย่อขนาดแบบดั้งเดิมเพิ่มจำนวนทรานซิสเตอร์ในพื้นที่หนึ่ง ๆ ด้วยการทำให้ส่วนประกอบมีขนาดเล็กลง ส่วน LogicFolding กระจายวงจรไปตามชั้นซิลิคอนที่ทำงานได้ และเชื่อมต่อชั้นเหล่านั้นด้วยจุดเชื่อมต่อแนวตั้งที่มีความหนาแน่นสูง การเชื่อมต่อที่เดิมต้องพาดผ่านระยะทางแนวนอนยาว สามารถใช้เส้นทางที่สั้นลงระหว่างชั้นได้
หัวเว่ยระบุว่าการออกแบบนี้ขยายผังวงจรจากชั้นทำงานหนึ่งชั้นเป็นสองชั้น ผลการวัดที่บริษัทเปิดเผยแสดงให้เห็นว่าความยาวเส้นทางเดินสัญญาณภายในคอร์ลดลง 20% และเส้นทางกำหนดเวลาสำคัญลดลงสูงสุด 70% เส้นทางวิกฤตเหล่านี้คือเส้นทางที่ความล่าช้าอาจจำกัดความเร็วในการทำงานของวงจร
สวีอธิบายว่าชิปประกอบด้วยชิ้นซิลิคอนเปลือยหลายชิ้น หรือได ซึ่งได้รับการออกแบบร่วมกันให้เป็นหน่วยประมวลผลที่สมบูรณ์ การจัดวางวงจรและจุดเชื่อมต่อได้รับการวางแผนในสามมิติตั้งแต่เริ่มต้น เพื่อให้แต่ละชั้นแบ่งงานกันได้อย่างมีประสิทธิภาพ
สายไฟที่สั้นลงช่วยลดความต้านทานและภาระทางไฟฟ้าที่ไม่พึงประสงค์ ทำให้สัญญาณไปถึงเร็วขึ้นและใช้พลังงานน้อยลง ขณะเดียวกัน การซ้อนชั้นทำให้กิจกรรมต่าง ๆ กระจุกอยู่ในพื้นที่เล็กลง จึงทำให้การระบายความร้อนเป็นโจทย์สำคัญทางวิศวกรรม
ตัวเลขประสิทธิภาพหมายถึงอะไร
ตัวเลขการปรับปรุงที่หัวเว่ยรายงานครอบคลุมการทำงานของหน่วยประมวลผลสามส่วนที่แตกต่างกัน CPU จัดการงานประมวลผลทั่วไป GPU วาดกราฟิก และ NPU ออกแบบมาสำหรับการคำนวณ AI ประสิทธิภาพ CPU ที่เพิ่มขึ้น 23% หมายถึงผลลัพธ์อยู่ที่ 1.23 เท่าของระดับเดิม ส่วนกำลังประมวลผล NPU ที่เพิ่มขึ้น 140% หมายถึง 2.4 เท่าของระดับเดิม
บริษัทยังรายงานว่าประหยัดพลังงานได้มาก เมื่อเทียบที่ประสิทธิภาพใกล้เคียงกัน ผลการวัดของบริษัทระบุว่าการใช้พลังงานของ NPU ลดลง 66% ของ GPU ลดลง 58% และของคอร์ CPU ลดลง 41% ในการบรรยายสรุปเดือนตุลาคม หัวเว่ยระบุแยกต่างหากว่าประสิทธิภาพการใช้พลังงานของคอร์ CPU ขนาดใหญ่ใน Kirin 9050 Pro ดีขึ้น 41%
ประสิทธิภาพการใช้พลังงานวัดปริมาณงานที่ทำได้ต่อพลังงานหนึ่งหน่วย ส่วนการใช้พลังงานวัดอัตราการใช้พลังงาน ทั้งสองตัวชี้วัดต้องอาศัยเงื่อนไขการทดสอบของตนเอง หัวเว่ยยังระบุว่าลดแรงดันไฟฟ้าและความเร็วสัญญาณนาฬิกาขณะทำงานเพื่อช่วยควบคุมความร้อน
สเปก Kirin 9050 Pro ที่มีการรายงานประกอบด้วย CPU เก้าคอร์ คอร์หลักทำงานที่ 3.1 GHz, GPU Maleoon 920 และ NPU Da Vinci สำหรับเจ้าของโทรศัพท์ ประโยชน์ที่ใช้งานได้จริงจะขึ้นอยู่กับการทำงานร่วมกันของส่วนประกอบเหล่านี้ระหว่างเล่นเกมเป็นเวลานาน ใช้แอปพลิเคชันที่ต้องประมวลผลสูง หรือส่งคำขอ AI ซ้ำ ๆ
จุดเชื่อมต่อนับล้านเชื่อมชั้นต่าง ๆ เข้าด้วยกัน
การเชื่อมต่อแบบไฮบริดใช้หน้าสัมผัสทางไฟฟ้าขนาดเล็กมากเชื่อมพื้นผิวซิลิคอนเข้าด้วยกัน หัวเว่ยระบุว่า Kirin 9050 Pro ใช้ระยะพิตช์ระหว่างจุดเชื่อมต่อ 1.5 ไมโครเมตร หมายความว่าระยะห่างระหว่างจุดเชื่อมต่อที่อยู่ติดกันประมาณ 1.5 ในพันส่วนของมิลลิเมตร
ตัวเลขการเชื่อมต่อต้องอธิบายอย่างรอบคอบ รายละเอียดแยกย่อยของหัวเว่ยระบุว่ามีจุดเชื่อมต่อมากกว่า 50 ล้านจุด และจุดเชื่อมต่อสัญญาณที่ใช้งานได้จริงมากกว่า 5 ล้านจุด ส่วนคำอธิบายอีกชุดจากการบรรยายสรุปเดือนตุลาคมเรียกจุดเชื่อมต่อมากกว่า 50 ล้านจุดว่าเป็นช่องทางเชื่อมต่อความเร็วสูง รายละเอียดแพ็กเกจที่มีการรายงานระบุว่าสัดส่วนที่ส่งสัญญาณใช้งานอยู่คิดเป็นราว 10% ถึง 15% ดังนั้นผู้อ่านควรแยกจำนวนจุดเชื่อมต่อทางกายภาพทั้งหมดออกจากจุดที่ใช้ส่งสัญญาณ
การผลิตจุดเชื่อมต่อเหล่านี้ต้องอาศัยการจัดแนวที่แม่นยำสูง การทำให้แผ่นเวเฟอร์บางลง และการขัดผิวให้เรียบ ช่องว่างเล็ก ๆ หรือหน้าสัมผัสทองแดงที่ไม่ตรงตำแหน่งอาจทำให้จุดเชื่อมต่อเสียหาย อัตราผลผลิต ซึ่งหมายถึงสัดส่วนชิปที่ผลิตแล้วทำงานได้ถูกต้อง มีความสำคัญเป็นพิเศษเมื่อชั้นที่ทำงานหลายชั้นต้องทำงานร่วมกัน
หัวเว่ยยังไม่ได้เปิดเผยโรงงานรับจ้างผลิตของ Kirin 9050 Pro โหนดการผลิต อัตราผลผลิต หรือเงื่อนไขการทดสอบประสิทธิภาพทั้งหมด ข้อมูลเหล่านี้จะช่วยประเมินต้นทุนการผลิตชิปและความสามารถในการทำซ้ำของผลลัพธ์ที่รายงาน
โมเดล AI ใช้หน่วยความจำน้อยลง
หัวเว่ยระบุว่า Kirin 9050 series สามารถเรียกใช้โมเดล AI ที่มีพารามิเตอร์ 30,000 ล้านตัว โดยใช้หน่วยความจำเพิ่มเติม 2.5 GB พารามิเตอร์คือค่าตัวเลขที่โมเดลเรียนรู้ระหว่างการฝึก ซึ่งช่วยให้โมเดลสร้างคำตอบได้
โมเดลนี้ใช้การออกแบบแบบ Mixture of Experts หรือเรียกย่อว่า MoE โดยแบ่งงานให้ส่วนต่าง ๆ ของโมเดลที่มีความเชี่ยวชาญเฉพาะด้าน และเปิดใช้งานเฉพาะส่วนที่เลือกไว้สำหรับงานนั้น วิธีนี้ช่วยลดปริมาณการประมวลผลที่ต้องใช้ต่อคำตอบ เมื่อเทียบกับการเปิดใช้งานโมเดลทั้งหมด
หัวเว่ยรายงานว่าประสิทธิภาพการโหลดโมเดลดีขึ้น 25% และการใช้หน่วยความจำลดลง 75% เมื่อเทียบกับรุ่นก่อนหน้า หากเทียบตามนี้ ความต้องการหน่วยความจำของรุ่นใหม่เหลือหนึ่งในสี่ของระดับเดิม บริษัทระบุว่าตัวเลข 2.5 GB หมายถึงหน่วยความจำที่ใช้เพิ่มเติม ไม่ใช่ความต้องการหน่วยความจำทั้งหมดของโทรศัพท์
การเรียกใช้โมเดล AI บนโทรศัพท์ทำให้ประมวลผลงานที่รองรับได้ภายในเครื่อง โดยไม่ต้องส่งทุกคำขอไปยังเซิร์ฟเวอร์ระยะไกล สำหรับผู้ใช้ เวลาโหลดและการใช้หน่วยความจำมีความสำคัญควบคู่กับกำลังประมวลผล โมเดลต้องใช้หน่วยความจำร่วมกับระบบปฏิบัติการและแอปพลิเคชันอื่นได้ และตอบสนองรวดเร็วพอที่จะใช้งานได้จริง
จากการประกาศเดือนพฤษภาคมสู่การเปิดเผยข้อมูลเดือนตุลาคม
หัวเว่ยเปิดเผยหลักการกว้าง ๆ เบื้องหลัง LogicFolding เมื่อวันที่ 25 พฤษภาคม ที่งาน IEEE International Symposium on Circuits and Systems 2026 เหอ ถิงป๋อ ประธานธุรกิจเซมิคอนดักเตอร์ของหัวเว่ย นำเสนอสิ่งที่บริษัทเรียกว่า Tau Scaling Law
ประกาศ Tau Scaling Law ของบริษัทเสนอให้ใช้การปรับขนาดตามเวลาเป็นหลักการชี้นำการพัฒนาเซมิคอนดักเตอร์ อักษรกรีก tau ใช้แทนค่าคงตัวเวลา ซึ่งเป็นค่าที่เกี่ยวข้องกับความรวดเร็วในการตอบสนองของวงจรไฟฟ้า แนวทางของหัวเว่ยมุ่งลดความล่าช้าตั้งแต่อุปกรณ์แต่ละชิ้นไปจนถึงระบบประมวลผลที่สมบูรณ์
การเปิดตัวดำเนินผ่านหลายช่วง:
- 25 พฤษภาคม 2026: หัวเว่ยนำเสนอ Tau Scaling Law และระบุว่าชิป Kirin ที่จะเปิดตัวในฤดูใบไม้ร่วงเป็นรุ่นแรกที่ใช้ LogicFolding
- 12 กันยายน 2026: เริ่มจำหน่าย Mate XT 2 Ultimate Design ในจีน โดยมีรายงานว่าใช้ Kirin 9050 Pro
- 1 ตุลาคม 2026: หัวเว่ยเปิดตัว Mate 90 Pro Max Collector's Edition พร้อม Kirin 9050 Pro
- 13 ตุลาคม 2026: หัวเว่ยเปิดเผยรายละเอียดสถาปัตยกรรมที่เซี่ยงไฮ้ และระบุว่าชิป Kirin รุ่นปี 2027 เริ่มอยู่ระหว่างการทดสอบแล้ว
หัวเว่ยระบุว่าได้ออกแบบและผลิตชิปจำนวนมาก 381 รุ่นภายใต้กรอบ Tau โดยรวมในช่วงหกปี สวีกล่าวว่าการสำรวจแนวทาง LogicFolding โดยเฉพาะเริ่มขึ้นเมื่อสี่ปีก่อน กรอบดังกล่าวครอบคลุมการปรับแต่งหลายประเภท ขณะที่ LogicFolding คือสถาปัตยกรรมวงจรเฉพาะที่กำลังเริ่มนำมาใช้ในผลิตภัณฑ์ Kirin
ทางเลี่ยงข้อจำกัดด้านอุปกรณ์ที่มาพร้อมต้นทุน
งานของหัวเว่ยดำเนินไปภายใต้ข้อจำกัดที่ปิดกั้นการเข้าถึงเครื่องลิโทกราฟีอัลตราไวโอเลตขั้นสูง (EUV) จากบริษัท ASML ของเนเธอร์แลนด์ เครื่องจักรเหล่านี้ช่วยให้ผู้ผลิตสร้างลวดลายวงจรขนาดเล็กมากได้ TSMC เริ่มผลิตชิปจำนวนมากด้วยกระบวนการ 2 นาโนเมตรแล้ว ขณะที่หัวเว่ยกำลังแสวงหาประสิทธิภาพผ่านการผสมผสานทางเลือกด้านการผลิตและการออกแบบในรูปแบบอื่น
นีล ชาห์ รองประธานฝ่ายวิจัยของ Counterpoint Research ระบุว่าความร้อน การบรรจุชิป และอัตราผลผลิตเป็นบททดสอบสำคัญของแนวทางหัวเว่ย
"อย่างไรก็ตาม เส้นทางเซมิคอนดักเตอร์คู่ขนานนี้ยังไม่ผ่านการพิสูจน์ในระดับการผลิตขนาดใหญ่ แนวทางนี้อาจทำให้เกิดข้อจำกัดด้านความร้อนและความซับซ้อนในการบรรจุชิปอย่างหนัก ซึ่งกระทบต่ออัตราผลผลิต" ชาห์กล่าว
ตัวเลขทางการเงินของหัวเว่ยสะท้อนขนาดการลงทุนของบริษัท การใช้จ่ายด้านการวิจัยและพัฒนาอยู่ที่ 121.38 พันล้านหยวนในช่วงครึ่งแรกของปี 2026 เพิ่มขึ้น 25.2% จากปีก่อน และคิดเป็น 25.9% ของรายได้ กำไรสุทธิลดลง 36% เหลือ 23.81 พันล้านหยวนในช่วงเวลาเดียวกัน
การเปิดตัวสินค้าเริ่มต้นที่ตลาดระดับราคาสูง Mate XT 2 โทรศัพท์ที่หน้าจอพับได้เป็นสามส่วน เริ่มวางจำหน่ายในจีนด้วยราคา 19,999 ถึง 24,999 หยวน หัวเว่ยยังระบุว่ายอดจัดส่งอุปกรณ์ที่ใช้ชิป Kirin ทะลุ 100 ล้านเครื่องแล้ว นับตั้งแต่ชิปกลับมาในเดือนสิงหาคม 2023 ทำให้โปรเซสเซอร์รุ่นต่อไปมีฐานผลิตภัณฑ์จำนวนมากรองรับ
เป้าหมายของหัวเว่ยสำหรับปี 2027 และ 2031
หัวเว่ยมีแผนลดระยะพิตช์ของการเชื่อมต่อแบบไฮบริดจาก 1.5 ไมโครเมตรเหลือ 1 ไมโครเมตรในปี 2027 หากผังวงจรเหมือนเดิม การลดระยะห่างในทั้งสองทิศทางจะทำให้ตำแหน่งเชื่อมต่อในพื้นที่หนึ่งเพิ่มขึ้นได้ในทางทฤษฎีราว 2.25 เท่า ความหนาแน่นที่ใช้งานได้จริงขึ้นอยู่กับการเดินสาย การจ่ายพลังงาน และข้อกำหนดด้านการผลิต
บริษัทระบุว่าซิลิคอนทดสอบของ Kirin รุ่นปี 2027 มีจุดเชื่อมต่อแนวตั้งมากกว่า 100 ล้านจุดแล้ว และสวีกล่าวว่าผลการทดสอบเป็นไปตามที่คาดไว้ หัวเว่ยยังกล่าวถึงเป้าหมายระยะพิตช์การเชื่อมต่อที่ 720 นาโนเมตรภายในสามปี และความเป็นไปได้ที่จะออกแบบให้มีชั้นทำงานสามหรือสี่ชั้นในอนาคต
เป้าหมายอย่างเป็นทางการของหัวเว่ยสำหรับปี 2031 คือความหนาแน่นของทรานซิสเตอร์เทียบเท่ากระบวนการ 14 อังสตรอม หรือ 1.4 นาโนเมตร ความหนาแน่นหมายถึงจำนวนทรานซิสเตอร์ที่บรรจุลงในพื้นที่หนึ่งได้ ส่วนกระบวนการผลิตยังกำหนดพฤติกรรมของทรานซิสเตอร์ คุณลักษณะด้านพลังงาน และข้อกำหนดการผลิต ดังนั้นเป้าหมายที่หัวเว่ยระบุจึงเกี่ยวข้องกับประสิทธิภาพชิปเพียงส่วนหนึ่ง
พอล ตรีโอลो หัวหน้าฝ่ายเทคโนโลยีประจำเอเชียและอเมริกาของ DGA Group ชี้ถึงความท้าทายที่ยังมีอยู่ด้านอัตราผลผลิต การใช้พลังงาน ความร้อน และประสิทธิภาพของอุปกรณ์ สวียังระบุด้วยว่ายังมีงานที่ต้องทำอีกหลายด้าน ทั้งเครื่องมือออกแบบ การชดเชยความแปรผันในการผลิต การควบคุมพลังงาน การเชื่อมต่อระหว่างชั้น และวิธีการทดสอบประสิทธิภาพ
เหตุใดความทะเยอทะยานจึงครอบคลุมมากกว่าสมาร์ตโฟน
กรอบ Tau ของหัวเว่ยยังครอบคลุมซอฟต์แวร์ สถาปัตยกรรมโปรเซสเซอร์ และระบบประมวลผลขนาดใหญ่ ในระดับชิป บริษัทกล่าวถึงการออกแบบซอฟต์แวร์และซิลิคอนร่วมกัน เพื่อให้คำสั่งและข้อมูลเคลื่อนที่ได้อย่างมีประสิทธิภาพ ส่วนในระดับระบบ แนวทาง UnifiedBus มุ่งลดความล่าช้าในการสื่อสารระหว่างกลุ่มอุปกรณ์ประมวลผลขนาดใหญ่ที่เรียกว่า SuperPoD
มาเตโอ บาเลโร ผู้อำนวยการ Barcelona Supercomputing Center กล่าวว่า ความสำเร็จขึ้นอยู่กับการประสานแอปพลิเคชัน ซอฟต์แวร์ สถาปัตยกรรมโปรเซสเซอร์ หน่วยความจำ และทรานซิสเตอร์เข้าด้วยกัน
"ทรานซิสเตอร์มีความสำคัญ แต่สิ่งที่สำคัญในตอนนี้คือพฤติกรรมของทั้งระบบ" บาเลโรกล่าว
นี่เป็นบททดสอบที่ใหญ่กว่าการเปิดตัวสมาร์ตโฟน ศูนย์ข้อมูลต้องป้อนข้อมูลให้โปรเซสเซอร์จำนวนมาก พร้อมจัดการการสื่อสาร การใช้ไฟฟ้า และการระบายความร้อน หัวเว่ยกล่าวถึงแผนขยาย LogicFolding ไปสู่การประมวลผลระดับองค์กร และเปิดตัวชิป AI Ascend 990 ภายในปี 2030
ความคืบหน้าของหัวเว่ยด้านการประมวลผล AI ภายในประเทศยังส่งผลต่อโอกาสทางการค้าของ Nvidia ในจีน จอร์จ เฉิน หุ้นส่วนและประธานร่วมฝ่ายดิจิทัลของ The Asia Group กล่าวว่าโอกาสที่ Nvidia จะขายชิปขั้นสูงอย่าง H200 ให้จีนกำลังแคบลง เมื่อทางเลือกในประเทศพัฒนาขึ้น
ในขณะนี้ ความสำเร็จที่เป็นรูปธรรมของหัวเว่ยคือการนำโปรเซสเซอร์ที่ออกแบบโดยอาศัยชั้นทำงานซึ่งเชื่อมต่อกันอย่างใกล้ชิดไปใช้เชิงพาณิชย์ตามที่รายงาน หลักหมายถัดไปคือ Kirin รุ่นปี 2027 การเชื่อมต่อที่หนาแน่นขึ้น และหลักฐานด้านประสิทธิภาพของสถาปัตยกรรมเมื่อทำงานต่อเนื่องและผลิตในปริมาณมากขึ้น
ประเด็นสำคัญ
- หัวเว่ยระบุว่าชิป Kirin 9050 นำ LogicFolding เข้าสู่การผลิตจำนวนมาก เพิ่มความหนาแน่นทรานซิสเตอร์ 53.5%
- ประสิทธิภาพที่รายงานเพิ่มขึ้น ได้แก่ CPU 23% กราฟิก 40% และกำลังประมวลผล NPU 140%
- การออกแบบใช้ชั้นทำงานสองชั้น โดยจุดเชื่อมต่อมีระยะห่าง 1.5 ไมโครเมตร
- หัวเว่ยระบุว่าชิป Kirin รุ่นปี 2027 อยู่ระหว่างการทดสอบ และมีแผนลดระยะพิตช์การเชื่อมต่อลงเหลือ 1 ไมโครเมตร
- เป้าหมายของบริษัทในปี 2031 คือความหนาแน่นทรานซิสเตอร์เทียบเท่ากระบวนการ 1.4 นาโนเมตร
- ความร้อน อัตราผลผลิต เครื่องมือออกแบบ และต้นทุนการผลิตยังเป็นความท้าทายสำคัญทางวิศวกรรม