วิสัยทัศน์ใหม่ในการควบคุมเกม
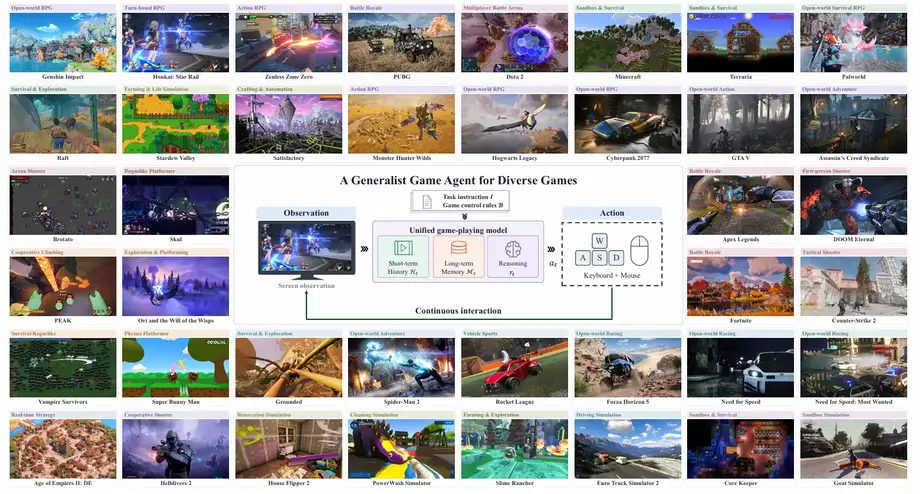
นักวิจัยของ miHoYo ซึ่งทำงานผ่านทีมวิจัยและพัฒนา AI ของ Honkai และร่วมมือกับสถาบันการศึกษาหลายแห่ง ได้เปิดตัวแบบจำลองฐานวิสัยทัศน์-ภาษา-การกระทำ (vision-language-action foundation model) ชื่อ Gamer โครงการนี้ทิ้งระบบแบบดั้งเดิมที่พึ่งพาอินเทอร์เฟซโปรแกรมประยุกต์ภายในของเกม (internal game APIs) หรือสถานะหน่วยความจำที่ถูกดัดแปลง แทนที่ด้วยกรอบการทำงานนี้ประมวลผลข้อมูลภาพดิบจากหน้าจอเกมและแปลงการสังเกตเหล่านั้นโดยตรงเป็นคำสั่งคีย์บอร์ดและเมาส์มาตรฐาน ทีมพัฒนารายละเอียดสถาปัตยกรรมพื้นฐานในพรีพรินต์ชื่อ Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent ตีพิมพ์บน arXiv โดยมีประวัติการส่งเริ่มต้นเมื่อวันที่ 13 พฤศจิกายน 2026 และแก้ไขครั้งสุดท้ายเมื่อวันที่ 18 พฤศจิกายน 2026 สถาบันวิจัยที่เข้าร่วม ได้แก่ มหาวิทยาลัยแห่งชาติสิงคโปร์ มหาวิทยาลัยชิงหัว มหาวิทยาลัยวิทยาศาสตร์แห่งประเทศจีน (University of Chinese Academy of Sciences) มหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีแห่งประเทศจีน และมหาวิทยาลัยเจียวทงซีอัน ทิศทางของโครงการมีบุคคลสำคัญเข้าเกี่ยวข้อง เช่น David Jiang ผู้ผลิตเกมหลักหลายเกมในแฟรนไชส์ Honkai และ Zheng Yinhe หัวหน้าทีมเทคนิคปัญญาประดิษฐ์สำหรับตัวละครที่ไม่ใช่ผู้เล่น (NPC) และรูปแบบการเล่นของซีรีส์ Honkai
สารบัญ
ต่างจากเอเจนต์ซอฟต์แวร์แบบดั้งเดิมที่ต้องการสิทธิ์พิเศษในการเข้าถึงรหัสเกม Gamer โต้ตอบกับสภาพแวดล้อมดิจิทัลเหมือนผู้เล่นมนุษย์ โมเดลจับภาพเฟรมหน้าจอที่ความถี่ 5 เฮิรตซ์ โดยใช้สัญญาณภาพเหล่านี้ร่วมกับคำสั่งงานและประวัติการสังเกตเพื่อกำหนดการกระทำที่เหมาะสม การตัดสินใจเหล่านี้ปรากฏเป็นชุดสถานะคีย์บอร์ดระดับต่ำและการเคลื่อนไหวเมาส์ที่ดำเนินการตามจังหวะควบคุม 30 เฮิรตซ์ ด้วยการปฏิบัติต่อการโต้ตอบของผู้ใช้ในฐานะรูปแบบร่วมกันที่ครอบคลุมทั้งอินเทอร์เฟซกราฟิกแบบดั้งเดิมและโลกจำลองสามมิติที่ซับซ้อน กรอบการทำงานนี้จึงมอบแนวทางที่เป็นหนึ่งเดียวสำหรับการนำทางและการดำเนินการในโลกดิจิทัล
กระบวนการฝึกและการเรียนรู้หลายระยะ
การสร้างเอเจนต์อัตโนมัติที่สามารถรักษาการเล่นเกมระยะยาวได้นั้นต้องก้าวไปไกลกว่าการปรับจูนคำสั่งหลายโหมดแบบมาตรฐาน ทีมวิจัยได้ดำเนินกระบวนการฝึกที่ครอบคลุมซึ่งแบ่งออกเป็นสามระยะที่ชัดเจน ระยะแรกเกี่ยวข้องกับการฝึกล่วงหน้าต่อเนื่อง (continued pretraining) บนชุดข้อมูลขนาดใหญ่ที่ประกอบด้วยเส้นทางการโต้ตอบคีย์บอร์ดและเมาส์ระดับอุปกรณ์หลายหมื่นชั่วโมง บันทึกการโต้ตอบเหล่านี้ครอบคลุมทั้งเกมจำลองและสภาพแวดล้อมแบบมีร่างกาย ทำให้โมเดลเรียนรู้พลวัตของสภาพแวดล้อมและความสัมพันธ์ระหว่างภาพและการเคลื่อนไหวในสภาพแวดล้อมดิจิทัลที่หลากหลาย ตามเอกสารของโครงการ ข้อมูลการฝึกรวมเส้นทางการโต้ตอบจากแหล่งต่าง ๆ เช่น VPT, D2E, OpenP2P และฟุตเทจบันทึกจาก Honkai: Star Rail
หลังจากการฝึกล่วงหน้าต่อเนื่อง โมเดลเข้าสู่การปรับจูนคำสั่งแบบให้เหตุผลบางเบา (sparse-reasoning instruction tuning) ในระยะนี้ กรอบการทำงานเรียนรู้ที่จะสร้างสมดุลระหว่างการเคลื่อนไหวทันทีกับการวางแผนอย่างรอบคอบ แทนที่จะสร้างข้อความอธิบายต่อเนื่องสำหรับทุกเฟรม โมเดลดำเนินการเคลื่อนไหวตามปกติโดยตรงในขณะที่สงวนบล็อกเหตุผลที่ชัดเจนไว้สำหรับจุดตัดสินใจสำคัญ เช่น ลำดับการแก้ปริศนาหรือตัวเลือกเนื้อเรื่อง ระยะฝึกสุดท้ายแนะนำวิธีการเรียนรู้เสริมแรงแบบออนไลน์ที่เรียกว่า Temporal-Aware Group Relative Policy Optimization เทคนิคนี้แก้ไขความท้าทายของหน้าต่างบริบทที่จำกัด ข้อผิดพลาดจากการรันเอาต์ที่สะสมระหว่างลำดับงานที่ยาว และรางวัลที่กระจัดกระจาย โดยเชื่อมช่วงต่าง ๆ ของเส้นทางเข้าด้วยกันผ่านสรุปหน่วยความจำถาวร
การจัดการหน่วยความจำและการดำเนินงานระยะยาว
การดำเนินงานที่ทอดยาวหลายชั่วโมงในการเล่นเกมก่อให้เกิดอุปสรรคสำคัญเกี่ยวกับการรักษาหน่วยความจำและขีดจำกัดของบริบท เมื่อเอเจนต์สำรวจโลกเสมือนกว้างใหญ่ การโต้ตอบในช่วงแรกจางหายไปจากหน้าต่างบริบทที่ใช้งานอยู่อย่างรวดเร็ว นำไปสู่ข้อผิดพลาดในการนำทางหรือเป้าหมายที่ถูกลืม เพื่อรักษาความคืบหน้าของงานโดยไม่ทำให้ระบบต้องรับภาระประวัติการสนทนาที่เติบโตขึ้นอย่างไม่รู้จบ นักวิจัยจึงรวมกลไกหน่วยความจำถาวรเข้าไว้ เมื่องานดำเนินไปและการโต้ตอบที่เก่ากว่าถูกดันออกจากบริบทที่ใช้งาน โมเดลจะสร้างสรุปที่กระชับซึ่งบันทึกหมุดหมายที่สำเร็จแล้ว ความพยายามที่ล้มเหลว สถานที่สำคัญ และแผนในลำดับถัดไป
ประสิทธิภาพของแนวทางการฝึกหลายระยะและการจัดการหน่วยความจำนี้ได้รับการประเมินผ่านการทดสอบอย่างเข้มข้นในสถานการณ์เล่นตามบทบาทเฉพาะ ในเควสรองที่ประเมินใน Honkai: Star Rail อัตราการสำเร็จหมุดหมายแสดงการปรับปรุงอย่างต่อเนื่องในแต่ละระยะการฝึก สำหรับเควสรองชื่อ Opportunity Makes the Thief (Part I) อัตราการสำเร็จหมุดหมายเพิ่มขึ้นจาก 34.4% หลังการฝึกล่วงหน้าต่อเนื่อง เป็น 72.2% หลังการปรับละเอียดแบบมีผู้ดูแล (supervised fine-tuning) และถึง 80.0% เมื่อนำการเรียนรู้เสริมแรงแบบออนไลน์มาใช้ เช่นเดียวกัน สำหรับเควสรอง Bestial Ferocity อัตราสำเร็จเพิ่มจาก 47.9% เป็น 69.1% และในที่สุดทำได้ 83.6% หลังการปรับให้เหมาะสมด้วยการเรียนรู้เสริมแรง ในชุดงานมินิเกมที่ไม่คุ้นเคย 40 งานที่ประเมิน รุ่นที่กำหนดชื่อว่า Gamer-RL ทำอัตราความสำเร็จเฉลี่ยได้ 49.7%
การอนุมานเรียลไทม์และสถาปัตยกรรมสตรีมมิง
การรักษาประสิทธิภาพสูงระหว่างการโต้ตอบเรียลไทม์ต้องทำให้เวลาหน่วงของการอนุมานอยู่ภายในเกณฑ์ความทนทานของซอฟต์แวร์เชิงโต้ตอบอย่างเหมาะสม เพื่อป้องกันความล่าช้าที่ทำให้เอเจนต์พลาดเหตุการณ์ไดนามิกในสภาพแวดล้อมที่ดำเนินไปอย่างรวดเร็ว ทีมพัฒนาจึงออกแบบระบบให้บริการแบบคลาวด์-เอจชื่อ Streaming-vLLM เครื่องยนต์อนุมานนี้ผสานการนำบริบทกลับมาใช้ซ้ำอย่างถาวร การถอดรหัสเชิงคาดเดาที่ยืนยันแล้ว และการส่งการกระทำล่วงหน้า เพื่อประมวลผลการรันแบบขนานอย่างมีประสิทธิภาพ การนำบริบทกลับมาใช้ซ้ำอย่างถาวรหลีกเลี่ยงการคำนวณซ้ำของสถานะหน้าจอในอดีตโดยการเก็บแคชคีย์-ค่าไว้ข้ามเฟรม ในขณะที่การส่งการกระทำล่วงหน้าจะส่งชุดคำสั่งคีย์บอร์ดชุดแรกที่ถูกต้องไปยังไคลเอนต์เกมก่อนที่โทเค็นถัดไปจะสร้างเสร็จ
เกณฑ์มาตรฐานประสิทธิภาพที่ระบุรายละเอียดในคลังเก็บของโครงการแสดงให้เห็นผลกระทบของการปรับให้เหมาะสมเหล่านี้ เมื่อทำงานในสภาพแวดล้อมที่ติดตั้งฮาร์ดแวร์ NVIDIA H200 และใช้การกำหนดค่าโมเดลบนพื้นฐาน Qwen3.5-35B-A3B โดยตั้งการประมวลผลขนานเทนเซอร์เป็น 4 ระบบพื้นฐานบันทึกเวลาหน่วงคำขอแบบต้นจรดปลาย (end-to-end) ได้ 1,306.00 มิลลิวินาที หลังนำการปรับให้เหมาะสมของ Streaming-vLLM มาใช้ เวลาหน่วงคำขอดังกล่าวลดลงเหลือ 65.12 มิลลิวินาที การลดเวลาดำเนินการนี้ทำให้ระบบรองรับการประเมินออนไลน์แบบพร้อมกันและรักษาวงจรควบคุมที่ตอบสนองได้ระหว่างการนำทางเชิงพื้นที่ที่ซับซ้อนและลำดับการต่อสู้
ขอบเขตการวิจัยและข้อจำกัดเชิงปฏิบัติ
การเผยแพร่กรอบการทำงานวิจัยนี้ก่อให้เกิดการถกเถียงอย่างกว้างขวางเกี่ยวกับศักยภาพที่เป็นไปได้และการใช้งานที่ตั้งใจไว้ เอกสารโครงการและแถลงการณ์สาธารณะจากทีมวิจัยเน้นย้ำว่า Gamer เป็นโครงการสำรวจทางวิชาการที่ออกแบบมาเพื่อศึกษาพฤติกรรมของเอเจนต์อเนกประสงค์ในสภาพแวดล้อมเชิงโต้ตอบ มิใช่เครื่องมือเชิงพาณิชย์ที่ได้รับอนุญาตสำหรับการบัญชีผู้เล่นอัตโนมัติหรือการสร้างความได้เปรียบในการแข่งขัน เพื่อจัดการข้อพิจารณาด้านความปลอดภัยข้อมูล ทีมงานได้ปกปิดข้อมูลการฝึกเฉพาะและน้ำหนักโมเดลที่เกี่ยวข้องกับเกมที่เป็นกรรมสิทธิ์ โดยเปิดให้เข้าถึงได้เฉพาะไฟล์ฝึกล่วงหน้าพื้นฐานและเอกสารระบบผ่านทรัพยากรต่าง ๆ เช่น Gamer GitHub repository เท่านั้น
การใช้งานจริงที่เป็นไปได้ซึ่งนักพัฒนากำหนดไว้เน้นไปที่ประโยชน์ในเชิงอุตสาหกรรมและการพัฒนามากกว่าระบบอัตโนมัติสำหรับผู้บริโภค กระบวนการทดสอบอัตโนมัติสามารถใช้ประโยชน์จากโมเดลดังกล่าวเพื่อทำการทดสอบโหลดข้ามเส้นทางเนื้อเรื่องที่แตกแขนงและโลกเสมือนกว้างใหญ่ ระบุข้อบกพร่องของการนำไปใช้ได้เร็วกว่าวิธีตรวจสอบด้วยมือแบบดั้งเดิม นอกจากนี้ หลักการพื้นฐานยังให้ข้อมูลเชิงลึกเกี่ยวกับความช่วยเหลือด้านการเข้าถึง (accessibility) และการวิจัยปฏิสัมพันธ์ระหว่างมนุษย์กับคอมพิวเตอร์ ปูทางสู่เอเจนต์ที่สามารถแปลงโหมดข้อมูลเข้าที่หลากหลายให้เป็นการกระทำดิจิทัลที่แม่นยำ
สาระสำคัญ
- กรอบการทำงานวิจัยพัฒนาโดยทีมวิจัยและพัฒนา AI ของ Honkai ที่ miHoYo ร่วมกับสถาบันการศึกษาต่าง ๆ รวมถึงมหาวิทยาลัยแห่งชาติสิงคโปร์และมหาวิทยาลัยชิงหัว
- ผลการวิจัยโดยละเอียดและคำอธิบายสถาปัตยกรรมมีบันทึกไว้ในพรีพรินต์ Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent
- ระบบจับการสังเกตหน้าจอดิบที่ความถี่ 5 เฮิรตซ์ และส่งออกคำสั่งคีย์บอร์ดและเมาส์ดั้งเดิมโดยไม่ต้องใช้อินเทอร์เฟซโปรแกรมประยุกต์ภายในหรือฮุกหน่วยความจำ
- ขั้นตอนการฝึกประกอบด้วยการฝึกล่วงหน้าต่อเนื่องบนเส้นทางการโต้ตอบหลายหมื่นชั่วโมง การปรับจูนคำสั่งแบบให้เหตุผลบางเบา และ Temporal-Aware Group Relative Policy Optimization
- เครื่องยนต์อนุมานเฉพาะ Streaming-vLLM ลดเวลาหน่วงคำขอจาก 1,306.00 มิลลิวินาที เหลือ 65.12 มิลลิวินาทีในการทดสอบด้วยฮาร์ดแวร์ NVIDIA H200
- ทีมวิจัยยืนยันว่าโครงการนี้เป็นการศึกษาทางวิชาการที่มุ่งสู่การประยุกต์ใช้งาน เช่น การทดสอบอัตโนมัติและการวิจัยด้านการเข้าถึง มิใช่เครื่องมือเชิงพาณิชย์สำหรับระบบอัตโนมัติในการเล่นเกม