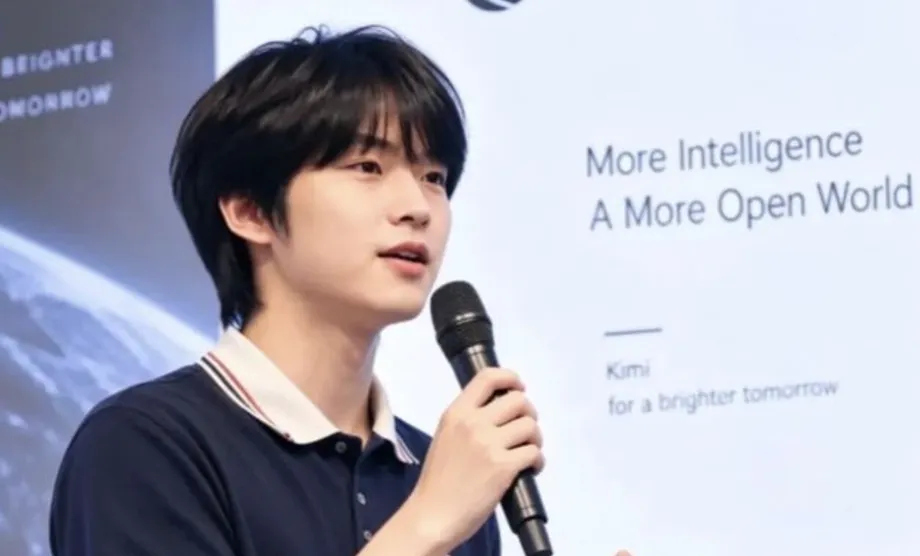
นักวิจัยวัยรุ่นลาออก หลังช่วยปรับโฉม Kimi
เฉิน กวางอวี่ นักวิจัยวัย 17 ปี ผู้มีส่วนพัฒนาวิธีใหม่ให้โมเดลปัญญาประดิษฐ์ส่งต่อข้อมูลระหว่างเลเยอร์ ประกาศเมื่อวันที่ 15 ตุลาคม 2026 ว่าเขาออกจาก Moonshot AI บริษัทจีนผู้พัฒนา Kimi เขาเข้าร่วมทีมวิจัยในเดือนพฤศจิกายน 2025 ขณะมีอายุ 16 ปี
สารบัญ
- นักวิจัยวัยรุ่นลาออก หลังช่วยปรับโฉม Kimi
- ผลงานวิจัยของเฉิน
- Attention Residuals เปลี่ยนโมเดลอย่างไร
- ผลการวิจัยที่เผยแพร่แสดงให้เห็นอะไร
- จากแฮกกาธอนในโรงเรียนสู่ทีมวิจัย
- ลำดับเหตุการณ์ของการเติบโตอย่างรวดเร็ว
- คำเชิญจาก Anthropic และเรื่องข้อเสนอค่าตอบแทนหลักล้านดอลลาร์
- เหตุใด Discovery Loop จึงเข้ามาอยู่ในกระแสพูดคุย
- การลาออกของเขาทิ้งอะไรไว้ที่ Moonshot
- ประเด็นสำคัญ
เฉิน ซึ่งเป็นที่รู้จักในระดับนานาชาติในชื่อ Nathan Chen ออกจากบริษัทพร้อมผลงานวิจัยที่เป็นรูปธรรม โดยเป็นผู้เขียนลำดับแรกในฐานะผู้มีส่วนร่วมเท่าเทียมกันของงาน Attention Residuals ซึ่งเผยแพร่เมื่อวันที่ 16 มีนาคม 2026 ร่วมกับนักวิจัย Moonshot อย่าง Yu Zhang และ Jianlin Su ตามรายงานเกี่ยวกับการเปิดตัวโมเดลในเดือนกรกฎาคม เทคนิคนี้ต่อมาได้เป็นส่วนหนึ่งของ Kimi K3
ผลการทดลองที่ Moonshot เผยแพร่ให้ภาพผลงานที่ชัดเจนกว่าความสนใจที่มุ่งไปยังอายุของเขา ในการทดสอบโมเดล Kimi Linear ที่มีพารามิเตอร์ 48,000 ล้านตัว นักวิจัยบันทึกผลพัฒนาการในทุกภารกิจที่ประเมิน วิธี Block Attention Residuals ของพวกเขายังทำผลขาดทุนในการฝึกได้เทียบเท่ากับโมเดลทั่วไปที่ใช้พลังประมวลผลมากกว่า 1.25 เท่า
การลาออกของเฉินทำให้เกิดทั้งคำเชิญอย่างเปิดเผยจาก Anthropic การคาดเดาเกี่ยวกับสตาร์ตอัปที่ก่อตั้งโดยอดีตนักวิจัย Google และความพยายามเชื่อมโยงเขากับวัยรุ่นนิรนามคนหนึ่ง ซึ่งมีรายงานว่าได้รับข้อเสนองาน 5 ข้อ แต่ละข้อมีมูลค่าประมาณ 1 ล้านดอลลาร์ขึ้นไป
อย่างไรก็ตาม เฉินปฏิเสธต่อสาธารณะว่าเขากำลังจะเข้าร่วม Anthropic นายจ้างรายต่อไปของเขา ค่าตอบแทน และแผนว่าจะกลับไปเรียนมหาวิทยาลัยหรือไม่ ยังไม่มีการยืนยัน
ในข้อความอำลา เฉินกล่าวถึงช่วงเวลาที่ Moonshot และขอบคุณผู้ที่รับเขาเข้าทำงาน นักศึกษาฝึกงานวิจัยด้านแมชชีนเลิร์นนิงที่กำลังจะจากไปกล่าวว่า:
ปีที่ผ่านมาเป็นช่วงเวลาที่ดีที่สุดในชีวิตของผม
ข้อความของเขาปิดท้ายด้วยความตั้งใจที่จะสำรวจสิ่งใหม่ต่อไป โดยไม่ได้ระบุว่าจะมุ่งหน้าไปที่ใด
ผลงานวิจัยของเฉิน
ชื่อของเฉินปรากฏร่วมกับ Zhang และ Su ในฐานะผู้มีส่วนร่วมเท่าเทียมกันใน รายงาน Attention Residuals ของทีม Kimi การระบุเช่นนี้ให้เครดิตทั้งสามคนว่าเป็นผู้นำในการมีส่วนร่วมกับงานที่ทีมขนาดใหญ่ร่วมกันดำเนินการ
Su ซึ่งเป็นที่รู้จักจากผลงานด้าน rotary position embeddings หรือ RoPE เป็นผู้ทำการทดลองเบื้องต้น RoPE ช่วยให้โมเดลภาษาติดตามตำแหน่งที่คำหรือข้อมูลส่วนอื่นปรากฏในลำดับได้ ส่วน Zhang เป็นผู้เขียนลำดับแรกของงานวิจัยสถาปัตยกรรม Kimi Linear
Su ให้เครดิต Zhang และเฉินว่าช่วยเปลี่ยนแนวคิด Attention Residuals ในระยะแรกให้เป็นสิ่งที่ใช้งานได้จริงกับโมเดลขนาดใหญ่ ทั้งสองร่วมกันเสนอ Block AttnRes ซึ่งเป็นเวอร์ชันที่ออกแบบมาเพื่อรักษาประโยชน์ของวิธีนี้ไว้ พร้อมลดภาระด้านหน่วยความจำและการสื่อสารเมื่อนำไปใช้ในวงกว้าง
เฉินยังทำงานเร่งความเร็วเคอร์เนลคำนวณสำหรับ Kimi Delta Attention หรือ KDA เคอร์เนลคือโปรแกรมขนาดเล็กที่ทำการคำนวณเฉพาะอย่างบนหน่วยประมวลผลกราฟิก การปรับปรุงเคอร์เนลช่วยให้อุปกรณ์ชุดเดิมทำงานเสร็จเร็วขึ้น
ดังนั้น งานของเขาจึงครอบคลุมสองด้านที่เกี่ยวเนื่องกัน ได้แก่ การตัดสินใจว่าจะสร้างโมเดลอย่างไร และการทำให้การคำนวณเบื้องหลังการออกแบบนั้นทำงานได้อย่างมีประสิทธิภาพ สำหรับห้องปฏิบัติการที่ฝึกโมเดลขนาดใหญ่ ทั้งสองด้านมีผลต่อปริมาณงานวิจัยที่ทำได้ภายใต้งบประมวลผลที่มี
Attention Residuals เปลี่ยนโมเดลอย่างไร
โมเดลภาษาประมวลผลข้อมูลผ่านเลเยอร์จำนวนมากที่เรียงต่อกัน แต่ละเลเยอร์แปลงข้อมูลที่ได้รับ แล้วสร้างตัวแทนข้อมูลที่เลเยอร์ถัดไปนำไปใช้ทำนายคำตอบ
การเชื่อมต่อแบบ residual ตามมาตรฐานช่วยส่งต่อข้อมูลเดิมผ่านกระบวนการนี้ โดยนำผลลัพธ์จากเลเยอร์ต่าง ๆ มาบวกกัน คลัง งานวิจัยทางการของ Moonshot อธิบายปัญหาของแนวทางนี้ว่า เมื่อโมเดลมีความลึกเพิ่มขึ้น การสะสมข้อมูลซ้ำ ๆ อาจทำให้สัดส่วนของแต่ละส่วนเจือจาง และทำให้ขนาดของสัญญาณภายในเพิ่มขึ้น
Attention Residuals แทนที่การสะสมข้อมูลแบบตายตัวด้วยกระบวนการคัดเลือกที่เรียนรู้ได้ เลเยอร์ที่อยู่ถัดไปสามารถให้น้ำหนักข้อมูลที่สร้างขึ้นก่อนหน้าแตกต่างกัน โดยขึ้นอยู่กับอินพุตปัจจุบัน ลองนึกถึงผู้อ่านที่ย้อนดูบันทึกจากบทก่อน ๆ เฉพาะส่วนที่เป็นประโยชน์ แทนที่จะต้องนำทุกบันทึกติดตัวไปข้างหน้าโดยให้น้ำหนักเท่ากัน
การคัดเลือกแยกกันในทุกเลเยอร์ก่อนหน้าทำให้เกิดต้นทุนขึ้นเอง Block AttnRes จัดกลุ่มเลเยอร์เข้าด้วยกัน โดยยังคงการบวกแบบปกติภายในแต่ละกลุ่ม แล้วเลือกจากตัวแทนข้อมูลของแต่ละกลุ่ม คลังระบุว่าการแบ่งเป็นประมาณ 8 กลุ่มให้ประโยชน์ส่วนใหญ่ใกล้เคียงกับวิธีเต็มรูปแบบ
การตั้งค่า Kimi Linear ที่ใหญ่ที่สุดซึ่งอธิบายในงานวิจัยใช้ 54 เลเยอร์ แบ่งกลุ่มละ 6 เลเยอร์ กลุ่มทั้ง 9 กลุ่มร่วมกับตัวแทนของโทเค็นเริ่มต้น ทำให้มีแหล่งข้อมูล 10 ส่วนสำหรับการคัดเลือก ขั้นตอนวิศวกรรมเชิงปฏิบัตินี้ช่วยขยับแนวคิดจากการทดลองไปสู่การฝึกโมเดลขนาดใหญ่
ผลการวิจัยที่เผยแพร่แสดงให้เห็นอะไร
งานวิจัยเดือนมีนาคมทดสอบ Attention Residuals กับโมเดล Kimi Linear ที่มีพารามิเตอร์รวม 48,000 ล้านตัว โดยเปิดใช้งาน 3,000 ล้านตัวระหว่างประมวลผล พารามิเตอร์คือค่าตัวเลขที่โมเดลเรียนรู้ การเปิดใช้งานเพียงบางส่วนช่วยให้โมเดลใช้คลังความรู้ที่เรียนรู้มาขนาดใหญ่ได้ ขณะจำกัดการคำนวณที่ต้องใช้ในแต่ละขั้นตอน
การฝึกใช้โทเค็น 1.4 ล้านล้านหน่วย ซึ่งเป็นส่วนย่อยของข้อความหรือข้อมูลประเภทอื่นที่โมเดลประมวลผล นักวิจัยคงองค์ประกอบหลักด้านสถาปัตยกรรมอื่น ๆ ของโมเดลไว้เหมือนเดิม เพื่อเปรียบเทียบการเพิ่ม Attention Residuals กับการออกแบบพื้นฐาน
คะแนน GPQA-Diamond ซึ่งเป็นแบบทดสอบคำถามวิทยาศาสตร์ที่ยาก เพิ่มจาก 36.9 เป็น 44.4 หรือเพิ่มขึ้น 7.5 คะแนน ส่วน HumanEval ซึ่งทดสอบการสร้างโค้ด เพิ่มจาก 59.1 เป็น 62.2 ขณะที่ MMLU ซึ่งเป็นเกณฑ์วัดความรู้ทั่วไป เพิ่มจาก 73.5 เป็น 74.6
การเปรียบเทียบด้านพลังประมวลผลก็มีประโยชน์เช่นกัน การทำผลได้เท่ากับโมเดลพื้นฐานที่ใช้พลังประมวลผลมากกว่า 1.25 เท่า หมายถึงได้ผลขาดทุนในการฝึกตามที่รายงานเท่ากัน โดยใช้ทรัพยากรเพียง 4 ใน 5 ของโมเดลพื้นฐาน หรือใช้พลังประมวลผลน้อยลง 20% ผลขาดทุนในการฝึกใช้วัดว่าการทำนายของโมเดลคลาดเคลื่อนจากคำตอบเป้าหมายเพียงใดระหว่างการฝึก
Moonshot ระบุแยกต่างหากว่าเทคโนโลยีนี้ช่วยเพิ่มประสิทธิภาพการฝึกของ K3 ได้ประมาณ 25% โดยมีภาระเพิ่มเติมน้อยกว่า 2% การทดลองในเดือนมีนาคมกับคำกล่าวอ้างภายหลังเกี่ยวกับ K3 เป็นผลจากการตั้งค่าโมเดลต่างกัน ตัวเลขเกณฑ์ทดสอบที่เผยแพร่โดยละเอียดข้างต้นมาจาก Kimi Linear
จากแฮกกาธอนในโรงเรียนสู่ทีมวิจัย
เฉินเกิดที่เมืองเซินเจิ้นในปี 2009 ก่อนเข้าร่วม Moonshot เขาจัดตั้งชุมชนโอเพนซอร์สสำหรับวัยรุ่น พัฒนาบอตซอฟต์แวร์ และสำรวจความสนใจหลากหลาย ตั้งแต่ความปลอดภัยของ AI ไปจนถึงฟิสิกส์
ระหว่างเตรียมสมัครเข้ามหาวิทยาลัย เขาพักกิจกรรมบางอย่างที่ไม่ชอบไว้ แล้วเริ่มอ่านเรื่องที่สนใจ เส้นทางสู่งานวิจัยหลังจากนั้นผสมผสานการเรียนรู้ด้วยตนเอง การเขียนเนื้อหาเชิงเทคนิคเผยแพร่ต่อสาธารณะ และการติดต่อกับนักวิจัยที่ทำงานอยู่
ในเดือนกุมภาพันธ์ 2025 เขาเข้าร่วมแฮกกาธอน AI สำหรับนักเรียนมัธยมของ Moonshot AI พร้อม ThirdArm โครงการที่นำเสนอแนวคิดแขนกลช่วยเหลือเพิ่มเติม ที่นั่นเขาได้พบกับ Dong Kehan สมาชิกทีมผู้ก่อตั้ง MiraclePlus ซึ่งสนับสนุนให้เขามุ่งเน้นเทคโนโลยีแนวหน้า
ต่อมา โพสต์เชิงเทคนิคเกี่ยวกับ DeltaNet ของเขาดึงดูดความสนใจจากนักวิจัย Songlin Yang การพูดคุยต่อไปถึง Ben Keigwin แห่ง Tilde Research สตาร์ตอัปในเมืองพาโลอัลโต รัฐแคลิฟอร์เนีย และนำไปสู่การพูดคุยเกี่ยวกับงานของบริษัท ในเดือนกรกฎาคม 2025 เฉินเดินทางไปที่นั่นเพียงลำพังขณะอายุ 16 ปี เพื่อฝึกงานเป็นเวลา 7 สัปดาห์
วิธีเรียนรู้ของเฉินรวมถึงการใช้เวลาหลายชั่วโมงพูดคุยเรื่องงานวิจัยกับ Gemini ส่งภาพหน้าจอของข้อความที่อ่านยาก และถามคำถามต่อยอด เขายังอ่านโค้ด บล็อก และเว็บไซต์ของนักวิจัย พร้อมขอคำแนะนำจาก Yuan Jingyang นักวิจัยของ DeepSeek ในเรื่องการตัดสินใจสำคัญ
ประสบการณ์ของเขาสะท้อนมากกว่าการใช้แชตบอตเป็นครูสอน การเขียนเผยแพร่สู่สาธารณะทำให้ผู้อื่นเห็นแนวคิดเชิงเทคนิคของเขา นักวิจัยตอบสนองต่อผลงานนั้น และการฝึกงานเปิดโอกาสให้เขานำแนวคิดไปต่อยอดเป็นงานร่วมกับผู้อื่น
ลำดับเหตุการณ์ของการเติบโตอย่างรวดเร็ว
เฉินก้าวจากโครงการในโรงเรียนไปสู่การฝึกงานระดับนานาชาติ แล้วต่อด้วยงานวิจัยเกี่ยวกับโมเดลที่เผยแพร่ภายในเวลาไม่ถึง 2 ปี การลาออกของเขาเกิดขึ้นหลัง Attention Residuals ถูกนำไปใช้ในผลิตภัณฑ์ Kimi รุ่นสำคัญ
- กุมภาพันธ์ 2025: เฉินเข้าร่วมแฮกกาธอน AI สำหรับนักเรียนมัธยมของ Moonshot
- กรกฎาคม 2025: เขาเริ่มฝึกงาน 7 สัปดาห์ที่ Tilde Research ในพาโลอัลโต
- พฤศจิกายน 2025: เขาเข้าร่วมทีม Kimi ของ Moonshot ในฐานะนักศึกษาฝึกงานวิจัยด้านแมชชีนเลิร์นนิง ขณะอายุ 16 ปี
- 16 มีนาคม 2026: รายงานทางเทคนิค Attention Residuals เผยแพร่ โดยระบุชื่อเฉิน Zhang และ Su ในฐานะผู้มีส่วนร่วมเท่าเทียมกัน
- มิถุนายน 2026: เฉินจบชั้นมัธยมปลาย
- กรกฎาคม 2026: เปิดตัว Kimi K3 ซึ่งมี Attention Residuals เป็นหนึ่งในเทคโนโลยีด้านสถาปัตยกรรม
- 15 ตุลาคม 2026: เฉินประกาศว่าเขาออกจาก Moonshot
- 16 ตุลาคม 2026: เขาปฏิเสธกระแสคาดการณ์ว่าจะเข้าร่วม Anthropic
- 20 ตุลาคม 2026: บัญชีนิรนามกล่าวอ้างว่าเขาเข้าร่วม Discovery Loop
ประวัติการศึกษาที่เปิดเผยต่อสาธารณะของเขายังระบุว่าเข้าเรียนที่ Carnegie Mellon University ในช่วงเดือนสิงหาคมและกันยายน 2026 ข้อมูลช่วงสั้น ๆ นี้กลายเป็นส่วนหนึ่งของการคาดเดาว่าก้าวต่อไปของเขาจะเป็นการทำงานหรือศึกษาต่อ
คำเชิญจาก Anthropic และเรื่องข้อเสนอค่าตอบแทนหลักล้านดอลลาร์
Sholto Douglas ผู้ดูแลด้านการเรียนรู้แบบเสริมกำลังที่ขยายขนาดได้ของ Anthropic แสดงความคิดเห็นในโพสต์อำลาของเฉิน เขาถามว่าเฉินยังวางแผนจะเข้าเรียนที่ Carnegie Mellon หรือไม่ และเชิญให้มาร่วมงานกันที่ซานฟรานซิสโก
เฉินตอบว่าเขากำลังมุ่งหน้าไปยังเบย์แอเรีย เมื่อการแลกเปลี่ยนดังกล่าวทำให้เกิดข้อเสนอแนะว่าเขาเข้าร่วม Anthropic แล้ว เขาตอบปฏิเสธสั้น ๆ ว่า:
ไม่ :)
การพูดถึงเงินเดือนเริ่มขึ้นแยกต่างหาก Deedy Das นักลงทุนจาก Menlo Ventures เล่าว่าเขาได้พบกับวัยรุ่นนิรนามวัย 17 ปีที่เรียนรู้ AI ด้วยตนเองโดยอาศัยโมเดลภาษา ฝึกงานประมาณ 1 ปีที่บริษัท AI ชั้นนำแห่งหนึ่ง และลาออกจากหลักสูตรปริญญาตรีของมหาวิทยาลัยชั้นนำในสหรัฐฯ หลังเรียนได้ 2 สัปดาห์
Das ระบุว่าวัยรุ่นคนนั้นได้รับข้อเสนอ 5 ข้อจากห้องปฏิบัติการ AI ชั้นนำในซานฟรานซิสโก แต่ละข้อมีมูลค่าประมาณ 1 ล้านดอลลาร์ขึ้นไป Das ยังเล่าด้วยว่าวัยรุ่นคนนั้นให้ความสำคัญกับการเรียนรู้มากกว่าเงิน
ผู้ใช้โซเชียลมีเดียเชื่อมโยงคำบรรยายดังกล่าวกับเฉิน เพราะอายุและประวัติด้านงานวิจัยของเขา Das ไม่ได้ระบุชื่อวัยรุ่นคนนั้น และเฉินก็ไม่ได้ยืนยันว่าข้อเสนอเหล่านั้นเป็นของเขา ดังนั้นการพูดคุยจึงเกี่ยวกับข้อเสนอที่มีรายงานว่าเป็นของบุคคลนิรนาม ไม่ใช่ข้อตกลงการจ้างงานของเฉินที่เปิดเผยต่อสาธารณะ
คำเชิญอย่างเปิดเผยจาก Douglas เป็นสัญญาณความสนใจที่ชัดเจนกว่า โดยนักวิจัยอาวุโสได้เชิญเฉินให้เข้าร่วมทีมต่อหน้าสาธารณะ ส่วนการปฏิเสธในเวลาต่อมาก็ให้คำตอบโดยตรงต่อกระแสคาดการณ์เรื่อง Anthropic
เหตุใด Discovery Loop จึงเข้ามาอยู่ในกระแสพูดคุย
Discovery Loop กลายเป็นจุดสนใจถัดมา หลัง Arfur Grok บัญชีนิรนามที่ติดตามการย้ายงานของบุคลากรด้าน AI กล่าวอ้างเมื่อวันที่ 20 ตุลาคมว่าเฉินเข้าร่วมบริษัทแล้ว เฉินยังไม่ได้ยืนยันการเข้าทำงาน และสตาร์ตอัปปฏิเสธที่จะแสดงความเห็นเกี่ยวกับเรื่องบุคลากร
บริษัทก่อตั้งขึ้นในเดือนสิงหาคม 2026 โดยอดีตนักวิจัย Google อย่าง Jeff Dean, Sanjay Ghemawat, Quoc Le และ Oriol Vinyals เป้าหมายที่บริษัทระบุคือการใช้ AI ทำงานวิจัยวิทยาศาสตร์และแมชชีนเลิร์นนิงให้เป็นระบบอัตโนมัติ ซึ่งรวมถึงการเสนอแนวคิด การทำการทดลอง และการวิเคราะห์ผล
สำหรับนักวิจัยที่สนใจการออกแบบโมเดลให้มีประสิทธิภาพ ภารกิจดังกล่าวเกี่ยวข้องกับโจทย์ทางเทคนิคที่คุ้นเคย ระบบที่ทำการทดลองวิจัยจำนวนมากต้องใช้ทรัพยากรประมวลผลอย่างมีประสิทธิภาพ และการพัฒนาอัลกอริทึมหรือเคอร์เนลอาจช่วยให้ทำการทดลองได้มากขึ้นภายใต้งบประมาณคงที่
การระดมทุนของ Discovery Loop ก็ได้รับความสนใจเช่นกัน มีรายงานว่าบริษัทต้องการระดมทุนในเดือนกันยายนโดยประเมินมูลค่าบริษัทไว้ราว 50,000 ล้านดอลลาร์ เทียบกับการหารือเรื่องมูลค่าประมาณ 10,000 ล้านดอลลาร์เมื่อไม่กี่สัปดาห์ก่อน ซึ่งเพิ่มขึ้น 5 เท่า ตัวเลขเหล่านี้เป็นมูลค่าบริษัทที่เสนอระหว่างการเจรจาระดมทุน
เฉินยังมีความเชื่อมโยงกับเบย์แอเรียอยู่แล้วผ่าน Tilde Research การฝึกงานก่อนหน้านี้ช่วยอธิบายได้ว่าการเดินทางไปแคลิฟอร์เนียอาจเกี่ยวข้องกับผู้ติดต่อในแวดวงอาชีพหลายคน ไม่ใช่จุดหมายที่ชัดเจนเพียงแห่งเดียว
การลาออกของเขาทิ้งอะไรไว้ที่ Moonshot
Du Yulun นักวิจัย Moonshot ผู้สนับสนุนการรับเฉินเข้าทำงานตอนอายุ 16 ปี กล่าวว่าเขากับเฉินพูดคุยกันยาวหลายครั้งเกี่ยวกับการตัดสินใจลาออก Du แสดงความเศร้าใจ แต่ก็สนับสนุนความต้องการของเฉินที่จะออกไปสำรวจความสนใจใหม่ ๆ ในวัยนี้
ผลงานของเฉินยังคงเป็นส่วนหนึ่งของประวัติงานวิจัยทีม Kimi K3 ซึ่งเปิดตัวในเดือนกรกฎาคมและมีพารามิเตอร์ 2.8 ล้านล้านตัว ผสาน Attention Residuals เข้ากับ Kimi Delta Attention ทั้งสองเทคโนโลยีจัดการข้อมูลคนละส่วน โดย AttnRes เปลี่ยนวิธีที่ข้อมูลเคลื่อนผ่านความลึกของโมเดล ส่วน KDA ช่วยประมวลผลลำดับข้อมูลได้อย่างมีประสิทธิภาพ
Moonshot ระบุว่าประสิทธิภาพการขยายขนาดของ K3 ดีขึ้นประมาณ 2.5 เท่าเมื่อเทียบกับ K2 โดยเป็นผลจากการเปลี่ยนแปลงด้านสถาปัตยกรรม วิธีฝึก และการเลือกข้อมูลร่วมกัน ผลงานของเฉินจึงเป็นส่วนหนึ่งของความพยายามในภาพรวมที่มีนักวิจัยหลายคนและการเปลี่ยนแปลงทางเทคนิคหลายด้าน
ผลในทางปฏิบัติไม่ได้จำกัดอยู่แค่เส้นทางอาชีพของพนักงานที่อายุน้อยเป็นพิเศษ โมเดลที่เรียนรู้ได้มีประสิทธิภาพขึ้นย่อมใช้ประโยชน์จากโปรเซสเซอร์ราคาแพงและงบวิจัยได้ดียิ่งขึ้น นักวิจัยที่เชื่อมโยงการออกแบบทางคณิตศาสตร์เข้ากับการนำไปใช้ที่รวดเร็วสามารถมีส่วนโดยตรงต่อเป้าหมายนี้
เฉินออกจาก Moonshot พร้อมผลงานที่เผยแพร่ ประสบการณ์จากสภาพแวดล้อมการวิจัย 2 แห่ง และความสนใจจากห้องปฏิบัติการชั้นนำอีกแห่ง เรื่องราวที่ยืนยันได้มีน้ำหนักอยู่แล้ว นั่นคือวัยรุ่นคนหนึ่งช่วยเปลี่ยนแนวคิดด้านสถาปัตยกรรมให้กลายเป็นวิธีที่ใช้งานได้จริง ก่อนเลือกออกไปสำรวจเส้นทางต่อไปโดยยังไม่ประกาศตำแหน่งใหม่
ประเด็นสำคัญ
- เฉิน กวางอวี่ หรือที่รู้จักในชื่อ Nathan Chen ประกาศลาออกจาก Moonshot AI เมื่อวันที่ 15 ตุลาคม 2026 ขณะอายุ 17 ปี
- เขาได้รับเครดิตเป็นผู้เขียนลำดับแรกในฐานะผู้มีส่วนร่วมเท่าเทียมกันร่วมกับ Yu Zhang และ Jianlin Su ในงาน Attention Residuals ซึ่งเผยแพร่เมื่อวันที่ 16 มีนาคม
- การทดลองของ Moonshot แสดงผลดีขึ้นในทุกภารกิจที่ประเมิน และทำผลได้เทียบเท่ากับโมเดลพื้นฐานที่ใช้พลังประมวลผลมากกว่า 1.25 เท่า
- เฉินช่วยพัฒนา Block AttnRes และทำงานเร่งความเร็วการคำนวณของ Kimi Delta Attention
- เขากล่าวว่ากำลังมุ่งหน้าไปยังเบย์แอเรีย และปฏิเสธกระแสคาดการณ์ว่าจะเข้าร่วม Anthropic
- ข้อกล่าวอ้างว่าเขาย้ายไป Discovery Loop และกระแสคาดการณ์ที่เชื่อมโยงเขากับข้อเสนอ 5 ข้อ มูลค่าข้อละประมาณ 1 ล้านดอลลาร์ ยังไม่มีการยืนยัน