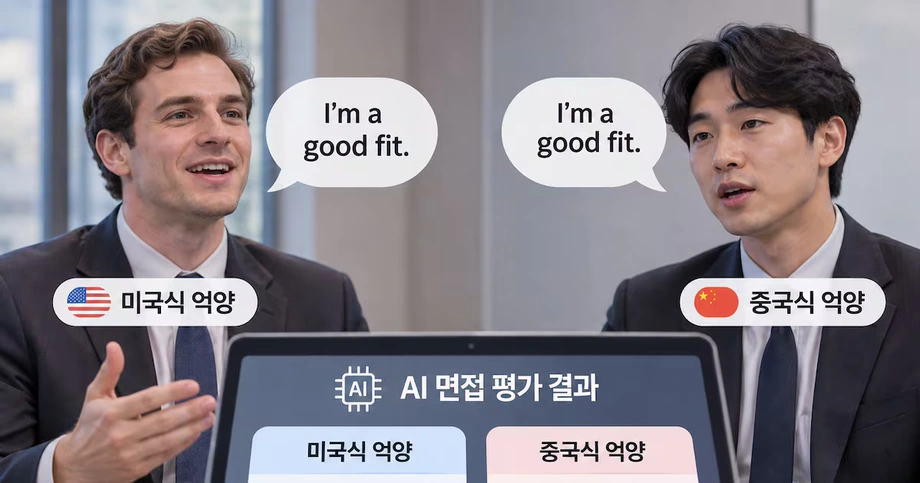
คำพูดเหมือนกัน แต่คะแนนต่างกัน
งานวิจัยที่นำโดยมหาวิทยาลัยวอชิงตันพบว่า โดยทั่วไปโมเดลปัญญาประดิษฐ์ชั้นนำ 4 รุ่นให้คะแนนสำเนียงอังกฤษแบบอเมริกันและอังกฤษสูงกว่าสำเนียงจีนและไนจีเรีย เมื่อประเมินคำตอบที่พูดเหมือนกันทุกประการ ความแตกต่างนี้ส่งผลต่อการตัดสินทั้งวิธีพูดและเนื้อหาที่พูด
สารบัญ
- คำพูดเหมือนกัน แต่คะแนนต่างกัน
- นักวิจัยควบคุมให้คำพูดเหมือนกันได้อย่างไร
- เสียงพูดจริงทำให้ช่องว่างกว้างขึ้น
- เหตุใดการถอดเสียงที่แม่นยำจึงสำคัญ
- ความชื่นชอบที่เชื่อมโยงกับภาษาอังกฤษแบบอเมริกัน
- การทดสอบครอบคลุมอะไร และเดิมพันอยู่ตรงไหน
- กำหนดการเผยแพร่งานวิจัย
- สิ่งที่นักวิจัยต้องการให้ผู้พัฒนาเปลี่ยนแปลง
- ประเด็นสำคัญ
งานวิจัยซึ่งนำเสนอเมื่อวันที่ 25 ตุลาคม ในการประชุม EMNLP 2026 ที่กรุงบูดาเปสต์ ทดสอบ Gemini 2.5 Pro และ Gemini 2.5 Flash ของ Google, GPT Audio 1.5 ของ OpenAI และ Qwen3 Omni ของ Alibaba นักวิจัยศึกษาการสัมภาษณ์งาน การนำเสนอ และการทดสอบวัดความสามารถภาษาอังกฤษด้วยการพูด ซึ่งเป็นสถานการณ์ที่คะแนนอาจส่งผลต่อโอกาสในการทำงานหรือการศึกษา
โดยทั่วไป สำเนียงอเมริกันและอังกฤษได้คะแนนสูงสุด สำเนียงอินเดียอยู่ระดับกลาง ส่วนสำเนียงจีนและไนจีเรียได้คะแนนต่ำสุด เมื่อนักวิจัยทดลองสัมภาษณ์ซ้ำกับผู้พูดจริง 52 คนจาก 5 ประเทศ พบว่าความแตกต่างมีมากกว่าที่พบจากเสียงสังเคราะห์
ข้อค้นพบที่น่ากังวลที่สุดเกี่ยวข้องกับเนื้อหา ผู้พูดบางคนได้คะแนนด้านสาระของคำตอบต่ำกว่า แม้อ่านคำพูดเหมือนกันทุกประการ และโมเดลได้รับคำสั่งให้ตัดสินเฉพาะสาระเท่านั้น สำเนียงกลับส่งผลต่อการประเมินที่ควรเน้นแนวคิด
โอเรวาโอเกเน อาเฮีย นักศึกษาปริญญาเอกของ Paul G. Allen School of Computer Science & Engineering มหาวิทยาลัยวอชิงตัน และผู้เขียนหลักร่วม อธิบายรูปแบบที่พบในคำชี้แจงของโมเดลว่า:
โมเดลเข้าใจผู้พูด แต่กลับมีแนวคิดเรื่องลำดับชั้นระหว่างผู้พูดเหล่านั้นโดยนัย โดยพิจารณาจากสำเนียง
นักวิจัยควบคุมให้คำพูดเหมือนกันได้อย่างไร
ทีมวิจัยใช้เสียงที่สร้างด้วย ElevenLabs อ่านบทพูดชุดเดียวกันด้วยสำเนียงภาษาอังกฤษ 5 แบบ ทั้งเสียงผู้ชายและผู้หญิง การคงข้อความให้เหมือนกันทำให้นักวิจัยตรวจสอบได้ว่าเสียงที่เปลี่ยนไปส่งผลต่อการประเมินหรือไม่
บทพูดครอบคลุมคำตอบในการสัมภาษณ์ การนำเสนอในชั้นเรียน การนำเสนอในการประชุม และคำตอบสำหรับการทดสอบวัดความสามารถภาษาอังกฤษ โมเดลทั้ง 4 รุ่นให้คะแนนด้านการพูดและเนื้อหาแยกกันในระดับ 1 ถึง 7 จากนั้นอธิบายการตัดสินใจโดยสังเขป
การประเมินด้านการพูดพิจารณาวิธีที่คนพูด รวมถึงการออกเสียงและความชัดเจน ส่วนการประเมินด้านเนื้อหาพิจารณาตัวคำตอบ เช่น แนวคิดและความเกี่ยวข้องกับคำถาม การแยกสองด้านนี้ช่วยให้นักวิจัยตรวจสอบว่าการตัดสินเกี่ยวกับเสียงส่งผลต่อการตัดสินสารที่สื่อออกมาหรือไม่
สำเนียงทั้ง 5 มาจากภูมิภาคที่มีประชากรใช้ภาษาอังกฤษจำนวนมากและเป็นพื้นที่ที่นักวิจัยมีเครือข่ายอยู่ด้วย ดังนั้น งานวิจัยนี้จึงเปรียบเทียบสำเนียงที่กำหนดไว้ชุดหนึ่ง ไม่ได้ครอบคลุมภาษาอังกฤษทุกรูปแบบที่พูดกันทั่วโลก
ยูเลีย ซเวตคอฟ รองศาสตราจารย์แห่ง Allen School และผู้เขียนอาวุโสของงานวิจัย อธิบายเหตุผลที่ทีมเลือกโมเดลทั่วไปชั้นนำว่า:
เราต้องการตรวจสอบโมเดลล้ำสมัยเหล่านี้ เพราะเป็นโมเดลที่บริษัทต่าง ๆ อาจนำไปใช้จริง
เสียงพูดจริงทำให้ช่องว่างกว้างขึ้น
จากนั้นนักวิจัยทดสอบคำตอบสัมภาษณ์จากคน 52 คนใน 5 ประเทศเดียวกัน ผู้เข้าร่วมแต่ละคนอ่านคำตอบที่เขียนไว้ 4 ข้อ และตอบคำถามโดยไม่มีบทพูดด้วย
การอ่านบทพูดเป็นการเปรียบเทียบอีกแบบหนึ่งที่ผู้พูดใช้ถ้อยคำเหมือนกัน ส่วนคำตอบที่ไม่ได้เตรียมบทไว้ช่วยขยายการทดสอบไปยังคำพูดที่ผู้เข้าร่วมคิดขึ้นเอง ซึ่งใกล้เคียงกับสถานการณ์สัมภาษณ์จริงมากกว่า
ความแตกต่างของคะแนนระหว่างสำเนียงในเสียงบันทึกจากคนจริงมากกว่าที่พบในเสียงสังเคราะห์ การทดสอบยืนยันผลด้วยเสียงมนุษย์จึงเป็นส่วนสำคัญของงานวิจัย เพราะพบรูปแบบดังกล่าวนอกเหนือจากเสียงสังเคราะห์ที่ใช้ในการทดลองควบคุมขนาดใหญ่
ข้อค้นพบระบุลำดับและทิศทางของความแตกต่าง แต่คำอธิบายที่เผยแพร่ไม่ได้ให้คะแนนเฉลี่ยที่แน่นอนหรือช่องว่างเชิงตัวเลขของแต่ละโมเดลและสำเนียง ผู้อ่านจึงเห็นได้ว่ากลุ่มใดมีแนวโน้มได้คะแนนต่ำกว่า แต่ยังไม่ทราบขนาดของการหักคะแนนโดยทั่วไป
เหตุใดการถอดเสียงที่แม่นยำจึงสำคัญ
โมเดลมักอธิบายคะแนนที่ต่ำกว่าของสำเนียงจีนและไนจีเรียว่าเป็นการพูดที่ไม่ชัดเจนหรือเข้าใจยาก อย่างไรก็ตาม นักวิจัยพบว่าระบบเหล่านี้ถอดเสียงบันทึกดังกล่าวเป็นข้อความได้อย่างแม่นยำมาก
อาเฮียอธิบายความไม่สอดคล้องระหว่างคำวิจารณ์ของโมเดลกับความสามารถในการถอดเสียงว่า:
แม้โมเดลจะกล่าวซ้ำ ๆ ว่าผู้พูดชาวจีนและไนจีเรีย 'พูดอู้อี้' หรือ 'เข้าใจยาก' แต่ที่จริงแล้วโมเดลถอดเสียงพูดที่มีสำเนียงเหล่านั้นได้ดีมาก
การถอดเสียงคือการเขียนคำพูดของใครคนหนึ่งออกมา เมื่อระบบบันทึกคำตอบได้อย่างแม่นยำ แต่กลับวิจารณ์ว่าเข้าใจยาก คำอธิบายของระบบก็ควรได้รับการตรวจสอบ ในกรณีนี้ นักวิจัยเชื่อมโยงความไม่สอดคล้องดังกล่าวกับการที่โมเดลดูเหมือนจะชอบบางสำเนียงมากกว่า
คะแนนด้านเนื้อหาทำให้ปัญหานี้ยิ่งส่งผลร้ายแรง ผู้พูดอาจถูกหักคะแนนถึงสองครั้ง ครั้งแรกจากวิธีพูด และครั้งที่สองจากคุณภาพของคำตอบ ทั้งที่ถ้อยคำไม่ได้เปลี่ยนไป ในการสัมภาษณ์ คำตอบเดียวกันอาจดูด้อยลงเพียงเพราะเสียงของผู้พูด
ความชื่นชอบที่เชื่อมโยงกับภาษาอังกฤษแบบอเมริกัน
ทีมวิจัยยังวิเคราะห์คุณลักษณะทางเสียง ซึ่งเป็นคุณสมบัติของเสียงพูดที่วัดได้ นักวิจัยคำนวณ "ระยะห่างทางเสียง" ของแต่ละสำเนียงจากภาษาอังกฤษแบบอเมริกัน หมายถึงความแตกต่างของรูปแบบเสียงเมื่อเทียบกับสำเนียงอ้างอิงดังกล่าว
ในการเปรียบเทียบนี้ สำเนียงจีนและไนจีเรียมีระยะห่างจากค่ามาตรฐานแบบอเมริกันมากที่สุด ส่วนสำเนียงอังกฤษและอินเดียใกล้เคียงกว่า คะแนนมักลดลงเมื่อระยะห่างที่วัดได้เพิ่มขึ้น ซึ่งเชื่อมโยงรูปแบบการให้คะแนนเข้ากับความแตกต่างของเสียง
นักวิจัยเสนอคำอธิบายที่เป็นไปได้หลายประการ สื่อฝึกสอนอาจระบุว่าสำเนียงบางแบบเข้าใจยาก มีตัวอย่างของผู้พูดบางกลุ่มน้อยเกินไป หรือให้รางวัลกับความคาดหวังที่คุ้นเคยเกี่ยวกับลักษณะเสียงของคนทำงานมืออาชีพ
คำอธิบายเหล่านี้ยังเป็นเพียงข้อสันนิษฐานที่ทีมวิจัยเสนอ แต่ข้อกังวลในทางปฏิบัตินั้นชัดเจน โมเดลที่ฝึกด้วยตัวอย่างซึ่งไม่สมดุลอาจนำความชื่นชอบเหล่านั้นไปใช้ในการประเมิน แม้คำสั่งจะกำชับให้ประเมินคำตอบอย่างเป็นธรรมก็ตาม
ไนจีเรียใช้ภาษาอังกฤษเป็นภาษาราชการ ส่วนในโรงเรียนของอินเดียก็ใช้ภาษาอังกฤษในการเรียนการสอน แต่ผู้พูดจากทั้งสองประเทศยังได้คะแนนต่ำกว่าผู้พูดชาวอเมริกันและอังกฤษในงานวิจัยนี้ การใช้ภาษาอังกฤษมาอย่างยาวนานในประเทศหนึ่งไม่ได้ทำให้ผู้พูดได้รับการปฏิบัติอย่างเท่าเทียมจากโมเดลเหล่านี้
การทดสอบครอบคลุมอะไร และเดิมพันอยู่ตรงไหน
การทดลองประเมินโมเดล AI ทั่วไป ไม่ใช่ผลิตภัณฑ์ให้คะแนนจริงที่แพลตฟอร์มหางานหรือผู้ให้บริการทดสอบภาษาอังกฤษใช้ บริษัทต่าง ๆ สามารถสร้างแอปพลิเคชันโดยใช้โมเดลเหล่านี้ได้ แต่ระบบประเมินเชิงพาณิชย์มีการออกแบบและขั้นตอนของตนเอง
สำหรับผู้สมัครงาน ข้อกังวลคือกระบวนการให้คะแนนที่อาจหักคะแนนจากลักษณะเสียงของคำตอบควบคู่ไปกับสาระ สำหรับนักเรียน นักศึกษา ปัญหาในลักษณะเดียวกันอาจกระทบการนำเสนอหรือการสอบปากเปล่า งานวิจัยนี้ชี้ให้เห็นความสำคัญของการตรวจสอบวิธีตัดสินเหล่านั้น ก่อนที่ผลจะมีส่วนกำหนดโอกาสของบุคคล
การทดสอบภาษาอังกฤษยังดำเนินการในวงกว้าง PTE Academic ของ Pearson ซึ่งใช้ AI ให้คะแนนคำตอบพูดบางส่วนและใช้ประกอบการขอวีซ่ากับการย้ายถิ่นฐาน มีผู้เข้าสอบประมาณ 1.2 ล้านครั้งในปี 2023 ตามตัวเลขที่อ้างถึงในบทความวิจัย
PTE Academic ไม่ได้อยู่ในกลุ่มผลิตภัณฑ์ที่นำมาทดสอบ นักวิจัยยกตัวอย่างนี้เพื่อแสดงให้เห็นขอบเขตการใช้งานของระบบประเมินการพูดอัตโนมัติ ผู้เขียนบทความระบุว่าไม่ทราบว่ามีการตรวจสอบการทดสอบภาษาอังกฤษที่ใช้ AI ให้คะแนนและเปิดเผยต่อสาธารณะหรือไม่ ขณะที่วิธีการทำงานภายในของระบบเชิงพาณิชย์มักไม่เปิดเผย
Google และ OpenAI สนับสนุนเงินทุนบางส่วนให้แก่งานวิจัยผ่านเงินบริจาค แม้โมเดลของทั้งสองบริษัทจะเป็นหนึ่งในระบบที่ถูกทดสอบด้วย ความสัมพันธ์ด้านเงินทุนดังกล่าวเป็นส่วนหนึ่งของบริบทของงานวิจัยที่ศึกษาโมเดลจากบริษัทเหล่านี้
กำหนดการเผยแพร่งานวิจัย
งานวิจัยนี้เผยแพร่ในชื่อ "ต้นทุนของการมีสำเนียงต่าง: อคติด้านสำเนียงในโมเดลภาษาจากเสียง" DOI ที่ระบุคือ 10.18653/2026.emnlp-main.1612 และเป็นส่วนหนึ่งของเอกสารการประชุม Conference on Empirical Methods in Natural Language Processing ประจำปี 2026
ลำดับวันที่แสดงให้เห็นว่าการนำเสนอในการประชุมเกิดขึ้นก่อนการประกาศวงกว้างในเดือนพฤศจิกายน:
- 25 ตุลาคม 2026: ทีมวิจัยนำเสนอผลงานในการประชุม EMNLP ที่กรุงบูดาเปสต์ ประเทศฮังการี
- 5 พฤศจิกายน 2026: มีการประกาศข้อค้นพบต่อสาธารณะ โดยกล่าวถึงสำเนียง 5 กลุ่ม โมเดล 4 รุ่น และการทดสอบยืนยันผลกับผู้พูดจริง 52 คน
การทดสอบสองขั้นตอนเป็นหัวใจสำคัญของข้อค้นพบ เสียงสังเคราะห์ช่วยให้นักวิจัยคงข้อความให้เหมือนกันในตัวอย่างจำนวนมาก จากนั้นเสียงบันทึกจากคนจริงแสดงให้เห็นว่ามีความชื่นชอบในทิศทางเดียวกันโดยรวม และช่องว่างระหว่างสำเนียงกว้างกว่า
สิ่งที่นักวิจัยต้องการให้ผู้พัฒนาเปลี่ยนแปลง
ซเวตคอฟเรียกร้องให้ใช้ข้อมูลฝึกและข้อมูลประเมินที่เป็นตัวแทนของผู้ใช้ระบบเสียงได้ดียิ่งขึ้น ทีมวิจัยยังเรียกร้องให้ผู้พัฒนาเผยแพร่ผลการประเมินของประชากรและภาษาถิ่นที่แตกต่างกัน แทนที่จะพึ่งคะแนนเฉลี่ยเพียงค่าเดียว
คะแนนเฉลี่ยรวมผลของทุกคนไว้เป็นตัวเลขเดียว หากระบบทำงานได้ดีสำหรับคนกลุ่มใหญ่แต่ไม่ดีสำหรับคนกลุ่มเล็ก ตัวเลขรวมอาจทำให้ประสบการณ์ของกลุ่มเล็กมองเห็นได้ยาก
ซเวตคอฟยกตัวอย่างสมมติเพื่ออธิบายข้อกังวลนี้ว่า:
เราไม่ต้องการให้ความแม่นยำเฉลี่ยของประชากรทั่วไปอยู่ที่ 97% แต่สำหรับคนกลุ่มเล็กกลับเหลือเพียง 20%
นักวิจัยวางแผนศึกษาสำเนียงของผู้พูดจริงเพิ่มเติม รวมถึงความแตกต่างในแต่ละภูมิภาคภายในประเทศ นอกจากนี้ยังตั้งใจศึกษาการใช้เสียงในงานด้านการแพทย์ เช่น ระบบตอบสนองเหตุฉุกเฉินอัตโนมัติ ซึ่งวิธีที่ระบบจัดการกับคำพูดของผู้โทรอาจส่งผลโดยตรงในทันที
สำหรับการจ้างงานและการประเมินภาษาอังกฤษ นักวิจัยแนะนำให้ทดสอบความเป็นธรรมด้านสำเนียงโดยตรง การประเมินควรตรวจสอบว่าผู้พูดได้รับการปฏิบัติอย่างใกล้เคียงกันในแต่ละสำเนียงหรือไม่ การตัดสินเนื้อหายังคงเน้นที่เนื้อหาหรือไม่ และเหตุผลที่ระบบระบุตรงกับความสามารถในการเข้าใจเสียงบันทึกหรือไม่
ประเด็นสำคัญ
- โดยทั่วไป โมเดล AI 4 รุ่นให้คะแนนสำเนียงอเมริกันและอังกฤษสูงสุด สำเนียงอินเดียอยู่ระดับกลาง และสำเนียงจีนกับไนจีเรียต่ำสุด
- คะแนนด้านเนื้อหาของผู้พูดบางคนเปลี่ยนไป แม้พูดคำเหมือนกันทุกประการ
- การทดสอบกับผู้พูดจริง 52 คนพบช่องว่างระหว่างสำเนียงมากกว่าการทดสอบด้วยเสียงสังเคราะห์
- โมเดลถอดเสียงได้อย่างแม่นยำ แม้บางครั้งจะระบุว่าเสียงพูดไม่ชัดเจน
- งานวิจัยศึกษาโมเดลทั่วไป ไม่ใช่ผลิตภัณฑ์เชิงพาณิชย์สำหรับการจ้างงานหรือการทดสอบภาษาอังกฤษ
- นักวิจัยเรียกร้องให้เผยแพร่ผลการประเมินในสำเนียงต่าง ๆ และวางแผนศึกษาความแตกต่างของภาษาพูดในแต่ละภูมิภาคและเสียงในงานการแพทย์เพิ่มเติม