โมเดลที่เรียนรู้ทั้งตัวอักษร RNA และการเชื่อมโยงระหว่างกัน
นักวิจัยจากมหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีแห่งประเทศจีนเผยแพร่ structRFM โมเดลพื้นฐานแบบเปิดสำหรับ RNA ซึ่งฝึกด้วยคู่ข้อมูลลำดับ RNA และโครงสร้างที่กำกับข้อมูลด้วยคอมพิวเตอร์จำนวน 21 ล้านคู่ การเผยแพร่ครั้งนี้ประกอบด้วยข้อมูลฝึกแบบจับคู่ น้ำหนักโมเดล และซอร์สโค้ด เพื่อให้ห้องปฏิบัติการอื่นนำวัสดุไปทำซ้ำงานวิจัยและปรับใช้ระบบได้
สารบัญ
- โมเดลที่เรียนรู้ทั้งตัวอักษร RNA และการเชื่อมโยงระหว่างกัน
- เหตุใดการพับตัวจึงสำคัญพอๆ กับลำดับ
- การรวบรวมคู่ข้อมูลฝึก 21 ล้านคู่
- ฝึกโมเดลด้วยข้อมูลที่ซ่อนไว้
- ผลการทดสอบโครงสร้าง
- จากการประมวลผล RNA สู่การจำแนกหน้าที่
- สิ่งที่นักวิจัยจะได้รับจากการเผยแพร่แบบเปิด
- ทีมวิจัยและกำหนดการตีพิมพ์
- ผลลัพธ์นี้เปลี่ยนแปลงงานวิจัย RNA อย่างไร
- ประเด็นสำคัญ
งานวิจัยซึ่งตีพิมพ์ใน Nature เมื่อวันที่ 4 พฤศจิกายน 2026 อธิบายโมเดลที่เรียนรู้ทั้งลำดับหน่วยพื้นฐานระดับโมเลกุลของ RNA และการเชื่อมโยงที่ช่วยให้โมเลกุลเหล่านั้นพับตัว การปรับโมเดลเพื่อทำนายโครงสร้างสามมิติซึ่งเรียกว่า Zfold ทำผลงานได้ในระดับที่ผู้เขียนระบุว่าเทียบเคียงกับ AlphaFold3 ในการประเมิน CASP15-natural, CASP16 และ RNA-Puzzles
จุดเด่นในทางปฏิบัติคือ หลังผ่านการฝึกแล้ว structRFM ต้องการเพียงลำดับ RNA เป็นข้อมูลนำเข้า โมเดลจะให้ข้อมูลที่นักวิจัยนำไปใช้กับงานหลายประเภทได้ รวมถึงการทำนายโครงสร้างโมเลกุล การระบุตำแหน่งที่เกี่ยวข้องกับการประมวลผล RNA และการจำแนกโมเลกุล RNA ตามหน้าที่
บทความวิจัยเรื่อง structRFM ใน Nature นำเสนอผลงานนี้ในฐานะแนวทางนำความรู้ด้านโครงสร้างไปใช้กับงานทำนายที่หลากหลาย Peng Xiong และ S. Kevin Zhou เป็นผู้เขียนที่รับผิดชอบการติดต่อ ส่วน Heqin Zhu เป็นผู้เขียนคนแรก
เหตุใดการพับตัวจึงสำคัญพอๆ กับลำดับ
RNA มีส่วนร่วมในการผลิตโปรตีน การควบคุมยีน และการประมวลผลสารพันธุกรรม ลำดับของ RNA คือการเรียงตัวของนิวคลีโอไทด์ ซึ่งเป็นหน่วยระดับโมเลกุลที่มักแทนด้วยตัวอักษร A, U, C และ G ลำดับดังกล่าวเก็บข้อมูลไว้ ขณะที่วิธีพับตัวของโมเลกุลช่วยกำหนดการทำงานของมัน
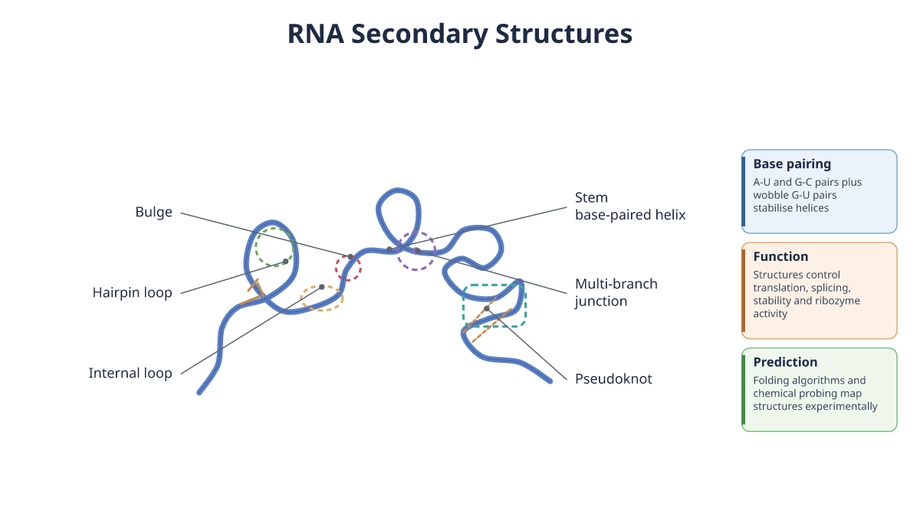
ส่วนต่างๆ ของสาย RNA สามารถจับคู่กับส่วนอื่นในสายเดียวกันได้ การเชื่อมโยงเหล่านี้ก่อให้เกิดโครงสร้างทุติยภูมิ ซึ่งเป็นรูปแบบของบริเวณที่จับคู่กัน ก้าน และห่วง จากนั้นโมเลกุลจะพับเป็นรูปร่างสามมิติที่เรียกว่าโครงสร้างตติยภูมิ ซึ่งส่งผลต่อกิจกรรมและปฏิสัมพันธ์กับโมเลกุลอื่น
โมเดลภาษาสำหรับ RNA จำนวนมากเรียนรู้รูปแบบจากชุดข้อมูลลำดับขนาดใหญ่ คล้ายกับที่โมเดลภาษาเรียนรู้ความสัมพันธ์ระหว่างคำ structRFM เพิ่มข้อมูลเกี่ยวกับนิวคลีโอไทด์ที่จับคู่กันระหว่างการฝึก จึงช่วยให้โมเดลเรียนรู้ความเชื่อมโยงระหว่างตำแหน่งที่อาจอยู่ห่างกันมากในลำดับ
นักวิจัยต้องการคงความยืดหยุ่นของโมเดลพื้นฐานไว้ ซึ่งเป็นระบบที่ผ่านการฝึกอย่างกว้างขวางและนำคุณลักษณะที่เรียนรู้ไปปรับใช้กับวัตถุประสงค์ต่างๆ ได้ เป้าหมายคือผนวกข้อมูลการพับตัวไว้ในพื้นฐานร่วมนี้ แทนการฝึกระบบที่ใช้ได้กับงานโครงสร้างเพียงงานเดียว
การรวบรวมคู่ข้อมูลฝึก 21 ล้านคู่
ทีมวิจัยสร้างชุดข้อมูลที่มีคู่ลำดับ RNA และโครงสร้างทุติยภูมิประมาณ 21 ล้านคู่ โดยสร้างข้อมูลกำกับโครงสร้างด้วยคอมพิวเตอร์ ทำให้นักวิจัยฝึกโมเดลได้ในขนาดใหญ่กว่าชุดข้อมูลที่ประกอบด้วยโครงสร้างซึ่งได้จากการทดลองในห้องปฏิบัติการเท่านั้นมาก
การทำนายด้วยคอมพิวเตอร์อาจมีข้อผิดพลาดและสะท้อนจุดแข็งจุดอ่อนของวิธีที่ใช้สร้างข้อมูล เพื่อลดการพึ่งพาตัวทำนายเพียงระบบเดียว นักวิจัยจึงพัฒนา MUSES ซึ่งเป็นชุดรวมการทำนายโครงสร้างทุติยภูมิจากหลายแหล่ง วิธีแบบชุดรวมจะประมวลข้อมูลจากแหล่งทำนายหลายแห่ง แทนการพึ่งพาแหล่งใดแหล่งหนึ่งทั้งหมด
MUSES มุ่งแก้ปัญหาสำคัญของการฝึกโมเดลด้วยโครงสร้างที่ทำนายไว้ กล่าวคือข้อผิดพลาดซ้ำๆ ในข้อมูลกำกับการฝึกอาจส่งผลต่อสิ่งที่โมเดลเรียนรู้ การรวมผลทำนายโครงสร้างได้รับการออกแบบมาเพื่อลดอคติจากตัวทำนาย พร้อมรักษาข้อมูลที่เป็นประโยชน์เกี่ยวกับการจับคู่ของเบสไว้
ทรัพยากรสำหรับการฝึกและประเมินผลในการศึกษานี้อ้างอิงฐานข้อมูลชีววิทยาที่เป็นที่ยอมรับ รวมถึง RNAcentral, Rfam และ Protein Data Bank รายละเอียดข้อมูลของงานวิจัยระบุเวอร์ชันที่เกี่ยวข้องไว้ ได้แก่ RNAcentral เวอร์ชัน 24.0 และ Rfam เวอร์ชัน 14.10 และ 15.0 เพื่อให้นักวิจัยตรวจสอบชุดข้อมูลที่ใช้ในการทดลองได้
ฝึกโมเดลด้วยข้อมูลที่ซ่อนไว้
structRFM ใช้วิธีสร้างแบบจำลองภาษาด้วยการปิดบังข้อมูล โดยซ่อนข้อมูลบางส่วนจากข้อมูลนำเข้า แล้วให้โมเดลเรียนรู้วิธีกู้คืนข้อมูลที่ขาดหายจากบริบทโดยรอบ สำหรับ RNA วิธีนี้หมายถึงการเรียนรู้ความสัมพันธ์ระหว่างนิวคลีโอไทด์แทนคำ
ทีมวิจัยผนวกการจับคู่ของเบสเข้ากับกระบวนการนี้ผ่านการดำเนินการจับคู่เป็นคู่ อัตราการปิดบังแบบปรับเปลี่ยนได้ช่วยถ่วงดุลการฝึกที่มีโครงสร้างการเชื่อมโยงเป็นแนวทาง กับการปิดบังที่ตำแหน่งนิวคลีโอไทด์แต่ละตำแหน่ง ทำให้โมเดลมีโอกาสเรียนรู้ทั้งรูปแบบลำดับเฉพาะบริเวณและความสัมพันธ์ที่เกี่ยวข้องกับการพับตัว
โมเดลที่ได้ให้คุณลักษณะสามประเภท ได้แก่ ข้อมูลเกี่ยวกับลำดับโดยรวม ข้อมูลของนิวคลีโอไทด์แต่ละตำแหน่ง และข้อมูลของนิวคลีโอไทด์ที่จับคู่กัน คุณลักษณะคือการแทนข้อมูลด้วยตัวเลข ซึ่งระบบทำนายอื่นสามารถนำไปใช้ได้ งานแต่ละประเภทสามารถเลือกใช้ข้อมูลแทนความรู้นี้ในระดับที่แตกต่างกัน
นักวิจัยยังทำการทดลองแบบตัดองค์ประกอบออก โดยนำส่วนต่างๆ ของโมเดลออกหรือเปลี่ยนแปลงเพื่อทดสอบว่าแต่ละส่วนมีส่วนช่วยอย่างไร ผลการทดลองสนับสนุนบทบาทของทั้งข้อมูลเชิงโครงสร้างและกลยุทธ์การปิดบังต่อการปรับปรุงผลงานที่รายงานไว้ และเป็นหลักฐานประกอบการเลือกออกแบบ structRFM
ผลการทดสอบโครงสร้าง
structRFM ทำผลงานได้ดีในการจำแนกความคล้ายคลึงทางวิวัฒนาการแบบ zero-shot ความคล้ายคลึงดังกล่าวเกี่ยวข้องกับความสัมพันธ์ที่สืบทอดมาจากต้นกำเนิดทางวิวัฒนาการร่วมกัน ในบริบทนี้ การจำแนกแบบ zero-shot ใช้ทดสอบว่าตัวแทนข้อมูลที่โมเดลเรียนรู้มีประโยชน์เพียงใดต่อการระบุความสัมพันธ์ดังกล่าว โดยไม่ฝึกเฉพาะกับงานจำแนกเป้าหมายนั้น
ผู้เขียนยังรายงานว่าการทำนายโครงสร้างทุติยภูมิดีขึ้น และโมเดลทำผลงานได้ดีในวงศ์ RNA ที่เพิ่งเผยแพร่ วงศ์ RNA คือกลุ่มโมเลกุลที่เกี่ยวข้องกันและมีคุณลักษณะด้านลำดับหรือโครงสร้างร่วมกัน การทดสอบกับวงศ์ที่เพิ่งเผยแพร่ช่วยประเมินว่าโมเดลทำงานได้ดีเพียงใดนอกเหนือจากกลุ่มที่คุ้นเคยและมีอยู่ในชุดข้อมูลที่ใช้กันมา
สำหรับการทำนายโครงสร้างตติยภูมิ ทีมวิจัยพัฒนา Zfold โดยปรับคุณลักษณะที่ structRFM เรียนรู้มาใช้กับโมเดลที่ทำนายรูปร่างสามมิติ ผู้เขียนรายงานว่าทั้งรูปร่างที่ทำนายได้และโครงสร้างทุติยภูมิที่สกัดจากผลทำนายมีการปรับปรุง
ทีมวิจัยประเมิน Zfold ด้วย CASP15-natural, CASP16 และ RNA-Puzzles ซึ่งเป็นชุดเกณฑ์มาตรฐานที่ใช้ประเมินการทำนายโครงสร้างโมเลกุล บทความระบุว่าผลงานของ Zfold เทียบเคียงกับ AlphaFold3 ในการประเมินเหล่านี้ การเปรียบเทียบดังกล่าวครอบคลุมผลของ Zfold บนเกณฑ์มาตรฐานที่ระบุ ส่วน structRFM ทำหน้าที่สร้างตัวแทนข้อมูล RNA ที่เป็นพื้นฐาน
งานวิจัยรายงานความสำเร็จหลายด้าน แทนการใช้คะแนนความแม่นยำเพียงค่าเดียวครอบคลุมทุกการใช้งาน การจำแนกลำดับที่เกี่ยวข้องกัน การทำนายคู่เบส และการสร้างรูปร่างสามมิติเป็นโจทย์ที่แตกต่างกัน โดยแต่ละโจทย์ต้องใช้การประเมินของตนเอง
จากการประมวลผล RNA สู่การจำแนกหน้าที่
ทีมวิจัยยังทดสอบ structRFM กับงานที่เกี่ยวข้องกับหน้าที่ของ RNA ซึ่งรวมถึงการทำนายตำแหน่งตัดต่อ RNA การระบุตำแหน่งเริ่มต้นการแปลรหัสภายในไรโบโซม และการจำแนก RNA ที่ไม่เข้ารหัสโปรตีน ทำให้การประเมินครอบคลุมมากกว่ารูปร่างของโมเลกุล
ตำแหน่งตัดต่อ RNA เป็นจุดแบ่งเขตที่เซลล์ใช้ในการประมวลผลสาร RNA ระหว่างการตัดต่อ ส่วนที่เลือกไว้จะถูกตัดออกและส่วนที่เหลือจะถูกนำมาต่อกัน การทำนายขอบเขตเหล่านี้ช่วยให้นักวิจัยศึกษาว่าสารพันธุกรรมถูกประกอบขึ้นอย่างไรก่อนนำไปใช้สร้างโปรตีน
ตำแหน่งเริ่มต้นการแปลรหัสภายในไรโบโซม หรือองค์ประกอบ IRES เป็นบริเวณของ RNA ที่ช่วยให้กลไกภายในเซลล์ซึ่งทำหน้าที่สร้างโปรตีนเริ่มการแปลรหัสจากตำแหน่งภายใน การระบุตำแหน่งเหล่านี้ต้องอาศัยการตรวจจับรูปแบบเชิงหน้าที่ภายในลำดับ จึงเป็นอีกบททดสอบหนึ่งของข้อมูลที่โมเดลเก็บเกี่ยวไว้ระหว่างการฝึกล่วงหน้า
RNA ที่ไม่เข้ารหัสโปรตีนทำหน้าที่อย่างอื่นนอกเหนือจากเป็นแม่แบบสำหรับการผลิตโปรตีน การจำแนก RNA กลุ่มนี้หมายถึงการจัดโมเลกุลเข้าสู่กลุ่มที่เกี่ยวข้อง ผู้เขียนรายงานว่าผลงานในงานเชิงหน้าที่เหล่านี้ดีขึ้น แสดงให้เห็นว่าตัวแทนข้อมูลที่เรียนรู้ยังมีประโยชน์แม้เปลี่ยนเป้าหมายการทำนายจากโครงสร้างเป็นบทบาททางชีววิทยา
ทีมวิจัยยังขยายโมเดลไปใช้จำแนก RNA ที่ไม่เข้ารหัสโปรตีนชนิดสายยาวด้วยกลยุทธ์การแบ่งส่วน การแบ่งลำดับที่ยาวออกเป็นช่วงๆ ช่วยให้ใช้โมเดลกับข้อมูลนำเข้าที่อาจประมวลผลเป็นหน่วยเดียวได้ยาก
สิ่งที่นักวิจัยจะได้รับจากการเผยแพร่แบบเปิด
การเผยแพร่ครั้งนี้ครอบคลุมทรัพยากรสามประเภทที่มีการใช้งานต่างกัน ชุดข้อมูลประกอบด้วยตัวอย่างที่ใช้ในการเรียนรู้ น้ำหนักโมเดลเก็บค่าตัวเลขที่เรียนรู้ระหว่างการฝึก ส่วนซอร์สโค้ดอธิบายการพัฒนาและการทำงานของซอฟต์แวร์
การเข้าถึงน้ำหนักโมเดลช่วยให้นักวิจัยเริ่มทำงานจากโมเดลที่ผ่านการฝึกแล้ว โดยไม่ต้องทำกระบวนการฝึกล่วงหน้าทั้งหมดซ้ำ การเข้าถึงข้อมูลและโค้ดช่วยให้ตรวจสอบขั้นตอนการฝึกได้ละเอียดขึ้น ทำซ้ำการทดลอง และพัฒนาแนวทางอื่น
บทความระบุที่เก็บโครงการบน GitHub ว่า heqin-zhu/structRFM นอกจากนี้ยังระบุคลังข้อมูลบน Zenodo สำหรับชุดข้อมูลฝึกล่วงหน้า ภายใต้ DOI 10.5281/zenodo.18272040 และคลังซอร์สโค้ดกับจุดตรวจสอบโมเดล ภายใต้ DOI 10.5281/zenodo.18274292 DOI คือตัวระบุถาวรที่มีจุดประสงค์เพื่อให้ติดตามทรัพยากรงานวิจัยได้ในระยะยาว
คำชี้แจงด้านข้อมูลระบุว่าชุดข้อมูลฝึกและทดสอบเปิดเผยต่อสาธารณะผ่านที่เก็บโครงการ นอกจากนี้ยังมีชุดข้อมูล IRES ที่ผ่านการประมวลผลและแบ่งส่วนตามที่ใช้ในการศึกษา รวมถึงข้อมูลต้นทางที่รองรับรูปภาพในบทความ ผู้เขียนระบุว่าไม่มีข้อจำกัดในการเข้าถึงข้อมูล
รายละเอียดเหล่านี้มีความสำคัญต่อการเปรียบเทียบ นักวิจัยตรวจสอบได้ว่าใช้ชุดข้อมูลและการแบ่งข้อมูลแบบใด สามารถประเมินผลซ้ำ และทดสอบได้ว่าการเลือกวิธีฝึกแบบอื่นทำให้ผลเปลี่ยนแปลงหรือไม่ ดังนั้น การเผยแพร่ครั้งนี้จึงเอื้อต่อการตรวจสอบข้อค้นพบและการนำโมเดลไปใช้ซ้ำ
ทีมวิจัยและกำหนดการตีพิมพ์
งานวิจัยนี้ดำเนินการโดยคณะวิศวกรรมชีวการแพทย์แห่งมหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีแห่งประเทศจีน และห้องปฏิบัติการด้านการถ่ายภาพทางการแพทย์ หุ่นยนต์ การประมวลผลเชิงวิเคราะห์ และการเรียนรู้ ซึ่งรู้จักกันในชื่อ MIRACLE ผู้เขียนระบุสังกัดในเมืองเหอเฝย์และสถาบันวิจัยขั้นสูงซูโจวของมหาวิทยาลัย ผู้เขียนร่วม Ruifeng Li สังกัดวิทยาลัยวิทยาการคอมพิวเตอร์และเทคโนโลยี มหาวิทยาลัยเจ้อเจียง ในเมืองหางโจว
Zhou ซึ่งเป็นศาสตราจารย์ และ Xiong ซึ่งเป็นนักวิจัยพิเศษ ร่วมกันริเริ่มและกำกับดูแลงานวิจัย Zhu ออกแบบและพัฒนากรอบการทำงาน ดำเนินการฝึกล่วงหน้า ทำการทดลองหลายรายการด้านการทำนายโครงสร้างและการจำแนก RNA ตลอดจนวิเคราะห์ผล สมาชิกทีมคนอื่นๆ รับผิดชอบการทดสอบความคล้ายคลึง การเปรียบเทียบชุดข้อมูล การระบุ IRES และการประเมินโครงสร้าง
การตีพิมพ์และการเผยแพร่ผลงานต่อสาธารณะเกิดขึ้นในสองวันตามปฏิทิน:
- 4 พฤศจิกายน 2026: Nature ระบุวันที่ตีพิมพ์บทความ An open structure-guided RNA foundation model for generalizable prediction
- 5 พฤศจิกายน 2026: มีการประชาสัมพันธ์ผลงานและการเผยแพร่แบบเปิดในประเทศจีน โดยระบุว่าบทความเผยแพร่ทางออนไลน์ในช่วงเช้ามืด
ผู้เขียนรายงานว่าได้รับการสนับสนุนจากมูลนิธิวิทยาศาสตร์ธรรมชาติแห่งชาติจีน โครงการวิจัยและพัฒนาสำคัญแห่งชาติ โครงการวิจัยในมณฑลเจียงซูและเมืองซูโจว และโครงการการแพทย์ซานหมิงในเมืองเซินเจิ้น พร้อมระบุว่าไม่มีผลประโยชน์ทับซ้อน
ผลลัพธ์นี้เปลี่ยนแปลงงานวิจัย RNA อย่างไร
structRFM นำกิจกรรมวิจัยหลายประเภทมาเริ่มต้นจากพื้นฐานร่วมกัน ห้องปฏิบัติการที่ศึกษาการประมวลผล RNA สามารถปรับใช้โมเดลพื้นฐานเดียวกับที่อีกกลุ่มหนึ่งใช้ศึกษาการพับตัวหรือจำแนกโมเลกุลที่ไม่เข้ารหัสโปรตีน อย่างไรก็ตาม แต่ละการประยุกต์ยังต้องพัฒนาและประเมินผลเฉพาะงานของตน
การผสานคู่ข้อมูลฝึก 21 ล้านคู่ การเรียนรู้ที่มีโครงสร้างเป็นแนวทาง และจุดตรวจสอบโมเดลที่เผยแพร่ ช่วยให้นักวิจัยตรวจสอบระบบที่นำไปใช้ได้จริง ไม่ใช่มีเพียงคำอธิบายอัลกอริทึม MUSES และการทดลองเรื่องการปิดบังยังนำเสนอทางเลือกในการออกแบบอย่างเป็นรูปธรรมให้ทีมอื่นทดสอบหรือปรับเปลี่ยนได้
ข้อค้นพบที่รายงานมุ่งเน้นการทำนายและการจำแนกด้วยคอมพิวเตอร์ การต่อยอดไปสู่การประยุกต์ใช้ทางชีวการแพทย์ต้องอาศัยการทดลองทางชีววิทยาเพิ่มเติม รวมถึงการตรวจสอบโครงสร้างที่ทำนายได้และทดสอบหน้าที่ที่กำหนดให้กับโมเลกุล RNA แต่ละชนิด
บทความไม่ได้ระบุกำหนดเวลาสำหรับการประยุกต์ใช้ทางคลินิก การเปลี่ยนแปลงที่เกิดขึ้นในทันทีคือการเปิดให้เข้าถึง นักวิจัยทั่วโลกสามารถรับทรัพยากรการฝึก ตรวจสอบการพัฒนาโมเดล และศึกษาว่าผลลัพธ์ที่รายงานนำไปใช้กับชุดข้อมูล RNA ของตนได้หรือไม่
ประเด็นสำคัญ
- นักวิจัยจากมหาวิทยาลัยวิทยาศาสตร์และเทคโนโลยีแห่งประเทศจีนเผยแพร่ structRFM โมเดลพื้นฐานสำหรับ RNA ซึ่งฝึกด้วยคู่ข้อมูลลำดับและโครงสร้างทุติยภูมิประมาณ 21 ล้านคู่
- โมเดลเรียนรู้รูปแบบลำดับและความสัมพันธ์ของการจับคู่เบส ก่อนสร้างคุณลักษณะโดยใช้เพียงลำดับเป็นข้อมูลนำเข้า
- MUSES รวมแหล่งทำนายโครงสร้างหลายแหล่ง ขณะที่การปิดบังแบบปรับเปลี่ยนได้ช่วยถ่วงดุลข้อมูลด้านโครงสร้างและนิวคลีโอไทด์ระหว่างการฝึก
- ผู้เขียนรายงานผลงานที่ดีในการจำแนกความคล้ายคลึงทางวิวัฒนาการและการปรับปรุงการทำนายโครงสร้างทุติยภูมิ รวมถึงการทดสอบกับวงศ์ RNA ที่เพิ่งเผยแพร่
- Zfold ซึ่งเป็นการปรับโมเดลเพื่อทำนายโครงสร้างตติยภูมิ ทำผลงานได้ในระดับที่ผู้เขียนระบุว่าเทียบเคียงกับ AlphaFold3 บนชุดเกณฑ์มาตรฐานสามชุด
- ชุดข้อมูล น้ำหนักโมเดล ซอร์สโค้ด และทรัพยากรสำหรับการประเมินผลเปิดให้สาธารณะนำไปใช้ซ้ำและทำซ้ำการวิจัยได้