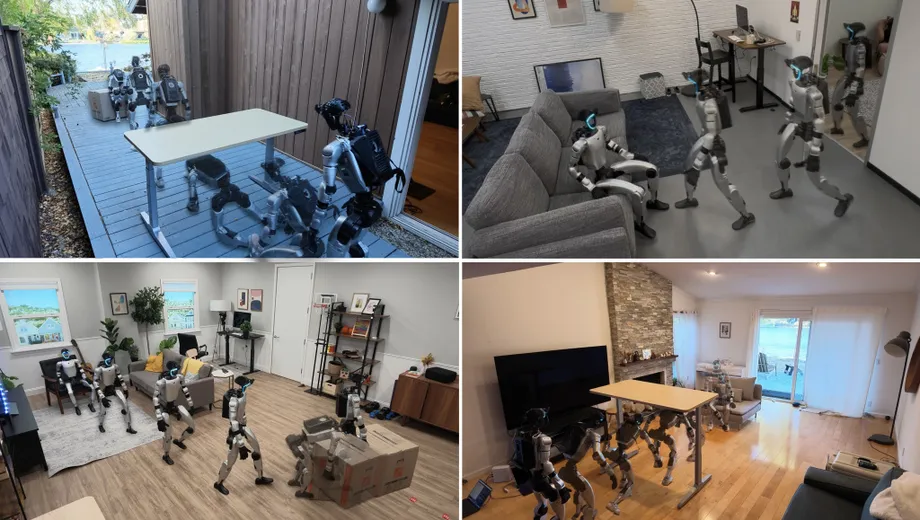
หุ่นยนต์ที่ฝึกในบ้านเสมือนจริงรับมือกับห้องจริง
นักวิจัยของ Apple ระบุว่า ระบบควบคุมหุ่นยนต์ฮิวแมนนอยด์ HALO ทำภารกิจทางกายภาพแต่ละอย่างสำเร็จเฉลี่ย 91% จากการทดลอง 360 ครั้ง ในสภาพแวดล้อมจริง 6 แห่งที่ไม่เคยสแกนหรือทำแผนที่ไว้ก่อน ระบบทำงานบน Unitree Robotics G1 โดยใช้สิ่งที่เรียนรู้จากการจำลองเพื่อเคลื่อนที่ในพื้นที่ที่ไม่คุ้นเคย นั่งบนเฟอร์นิเจอร์ ผ่านช่องแคบ และดันกล่อง
สารบัญ
- หุ่นยนต์ที่ฝึกในบ้านเสมือนจริงรับมือกับห้องจริง
- ตัวเลขความสำเร็จ 91% ครอบคลุมอะไรบ้าง
- เหตุใดคำสั่งที่มีหลายขั้นตอนจึงยากกว่า
- สามชั้นเปลี่ยนคำสั่งให้เป็นการเคลื่อนไหว
- Mac mini ติดตั้งอยู่บน G1
- บ้านเสมือน 1,000 หลังใช้สร้างตัวอย่างฝึกอย่างไร
- ต้นทุนการประมวลผลและงานของมนุษย์
- การมองเห็นยังแก้ปัญหาเรื่องการสัมผัสไม่ได้
- งานวิจัยนี้เปลี่ยนแปลงอะไร
- ประเด็นสำคัญ
ผลการศึกษาปรากฏในงานวิจัยชื่อ Perceptive Humanoid Motion from Simulation ซึ่งส่งให้ arXiv เมื่อวันที่ 4 พฤศจิกายน 2026 บทความของทีม Apple อธิบายการฝึกด้วยตัวอย่างสังเคราะห์ราว 300 ชั่วโมง ในสภาพแวดล้อมบ้านที่สร้างด้วยคอมพิวเตอร์ 1,000 รูปแบบ ก่อนนำระบบไปใช้กับหุ่นยนต์จริงโดยตรง
ภารกิจที่ต่อเนื่องหลายขั้นตอนทำได้ยากกว่า ในสภาพแวดล้อมจริงอีกแห่ง HALO ทำภารกิจที่ประกอบด้วยชุดการกระทำ 3 แบบสำเร็จเฉลี่ย 70% โดยแต่ละแบบทดลอง 10 ครั้ง ลำดับที่ต้องก้มลอดสิ่งกีดขวาง เข้าใกล้เป้าหมาย และดันกล่อง ทำสำเร็จ 5 จาก 10 ครั้ง
ความก้าวหน้าที่นำไปใช้ได้จริงคือการเชื่อมโยงความเข้าใจคำสั่งเข้ากับการเคลื่อนไหวของร่างกายทั้งตัวผ่านพื้นที่ที่มีเฟอร์นิเจอร์และไม่คุ้นเคย คำสั่งอย่างการนั่งบนเก้าอี้ทำให้หุ่นยนต์ต้องระบุที่นั่ง หาเส้นทาง จัดตำแหน่งร่างกาย และรักษาสมดุลขณะหย่อนตัวลงนั่ง HALO แบ่งหน้าที่เหล่านี้ให้ชั้นควบคุม 3 ชั้นที่ทำงานร่วมกัน
ผู้เขียนงานวิจัย ได้แก่ Siyuan Hu, Abulikemu Abuduweili, Yue Meng, Shipeng Liu, Quentin Leboutet, Chen Chen, Matthias Müller และ Vladlen Koltun ซึ่งทุกคนระบุสังกัด Apple นอกจากนี้ พวกเขายังเผยแพร่โค้ดที่ครอบคลุมการสร้างข้อมูล การฝึก และการนำไปใช้งาน รวมถึงการวางแผนภารกิจ การสร้างการเคลื่อนไหว และการติดตามการเคลื่อนไหวทั้งในการจำลองและบนหุ่นยนต์จริง
ตัวเลขความสำเร็จ 91% ครอบคลุมอะไรบ้าง
ทักษะย่อยทั้ง 6 อย่างมีอัตราความสำเร็จแตกต่างกัน การย่อตัวทำได้ดีที่สุด ส่วนการนั่งเป็นการกระทำที่มีอัตราความสำเร็จน้อยที่สุดในการทดสอบ:
- เดินไปยังวัตถุที่ระบุ: 92%
- นั่งบนเฟอร์นิเจอร์: 85%
- ผ่านประตูที่เปิดแง้มไว้: 93%
- ย่อตัวลอดใต้สิ่งกีดขวาง: 100%
- คลานลอดใต้สิ่งกีดขวาง: 90%
- ดันกล่อง: 88%
อัตราความสำเร็จของการย่อตัวกับการนั่งต่างกัน 15 จุดเปอร์เซ็นต์ การนั่งไม่ได้ต้องแค่ไปให้ถึงตำแหน่งที่ถูกต้องเท่านั้น หุ่นยนต์ต้องจัดแนวตัวให้ตรงกับเฟอร์นิเจอร์และถ่ายน้ำหนักลงบนที่นั่งด้วย จึงต้องอาศัยทั้งความเข้าใจภาพและระบบควบคุมทางกายภาพ
สภาพแวดล้อมทั้ง 6 แห่งที่ใช้ประเมินผลไม่คุ้นเคยกับ HALO นักวิจัยไม่ได้สแกนสถานที่เหล่านั้นไว้ล่วงหน้า และไม่ได้ใช้ระหว่างการฝึก บทความเรียกวิธีนี้ว่าการถ่ายโอนแบบ zero-shot หมายถึงระบบเปลี่ยนจากการฝึกในสถานการณ์จำลองไปทำงานในสภาพแวดล้อมจริงเหล่านั้นได้ โดยไม่ต้องฝึกเพิ่มเติมสำหรับแต่ละสถานที่
วิดีโอสาธิตยังแสดง G1 เดินตามคน นั่งบนโซฟา เคลื่อนตัวด้านข้างผ่านประตูที่เปิดแง้มไว้ และก้มหรือคลานลอดใต้โต๊ะ การเคลื่อนไหวเหล่านี้แสดงให้เห็นว่าระบบปรับท่าทางตามพื้นที่รอบตัว แทนที่จะเพียงเดินตรงไปยังจุดหมาย
เหตุใดคำสั่งที่มีหลายขั้นตอนจึงยากกว่า
ชุดภารกิจ 3 แบบของ HALO ให้ผลลัพธ์ที่หลากหลายกว่า การผ่านประตูแล้วเดินไปยังเป้าหมายสำเร็จทั้ง 10 ครั้ง การย่อตัวแล้วนั่งสำเร็จ 6 ครั้ง ส่วนการย่อตัว เข้าใกล้เป้าหมาย แล้วดันกล่องสำเร็จ 5 ครั้ง
เมื่อนับรวม ทำได้สำเร็จ 21 ลำดับจากทั้งหมด 30 ครั้ง หรือ 70% ซึ่งต่ำกว่าค่าเฉลี่ยของภารกิจเดี่ยว 21 จุดเปอร์เซ็นต์ อย่างไรก็ตาม การทดสอบแบบลำดับใช้สภาพแวดล้อมต่างออกไปและมีจำนวนครั้งทดลองน้อยกว่า
การทำงานเป็นลำดับเปิดโอกาสให้เกิดปัญหาได้มากขึ้น เพราะผลลัพธ์ของการเคลื่อนไหวหนึ่งกลายเป็นตำแหน่งเริ่มต้นของการเคลื่อนไหวถัดไป ตัวอย่างเช่น เมื่อลอดใต้สิ่งกีดขวางแล้ว หุ่นยนต์ต้องอยู่ในตำแหน่งที่ยังเดินเข้าใกล้เป้าหมายและทำการเคลื่อนไหวขั้นต่อไปได้
HALO รับมือกับเรื่องนี้ด้วยการตรวจสอบภาพ นักวางแผนจะดูวิดีโอจากมุมมองของหุ่นยนต์ ประเมินว่าการกระทำปัจจุบันสำเร็จหรือไม่ แล้วตัดสินใจว่าจะทำขั้นต่อไปหรือลองใหม่ ผลการทดลองชี้ว่าการเชื่อมทักษะต่าง ๆ เข้าด้วยกันยังเป็นโจทย์ที่ยากกว่าการทำแต่ละทักษะแยกกัน
สามชั้นเปลี่ยนคำสั่งให้เป็นการเคลื่อนไหว
ชั้นควบคุมระดับสูงสุดทำหน้าที่วางแผนภารกิจ โดยใช้โมเดลวิชัน-ภาษา ซึ่งเป็น AI ประเภทที่ประมวลผลทั้งภาพและคำ เพื่อแปลความคำสั่งควบคู่กับสิ่งที่กล้องมองเห็น โมเดลเริ่มต้นคือ Qwen3.6-35B-A3B ซึ่งทำงานในเครื่อง Mac mini ที่หุ่นยนต์พกติดตัว
ระบบเรียกใช้นักวางแผนทุก 2 วินาที หากมีคนสั่งให้หุ่นยนต์นั่งโดยไม่ระบุที่นั่ง ระบบต้องเลือกวัตถุที่เหมาะสมจากสิ่งที่มองเห็น หากมีโต๊ะขวางเส้นทางไปยังเก้าอี้ ระบบสามารถแบ่งคำสั่งเป็นการกระทำย่อย เช่น ก้มลอดสิ่งกีดขวาง เดินเข้าใกล้เก้าอี้ แล้วนั่งลง
ชั้นกลางเปลี่ยนภารกิจย่อยแต่ละอย่างให้เป็นแผนการเคลื่อนไหว โดยผสาน Qwen3.5-2B ซึ่งคงค่าพารามิเตอร์ของตัวเข้ารหัสไว้ระหว่างการฝึก เข้ากับตัวถอดรหัสแบบ diffusion transformer ที่สร้างการเคลื่อนไหวทั้งร่างกาย ตัวเข้ารหัสแปลงภาพและคำสั่งเป็นข้อมูลที่โมเดลการเคลื่อนไหวใช้ได้ ส่วนตัวถอดรหัสสร้างท่าทางตามแผน
ชั้นนี้มองไปข้างหน้าราว 5 วินาที และวางแผนใหม่ประมาณ 3 ครั้งต่อวินาที จึงปรับการเคลื่อนไหวที่ตั้งใจไว้จากภาพกล้องที่รับเข้ามาใหม่อยู่เสมอ แทนที่จะสั่งการต่อเนื่องครบ 5 วินาทีโดยไม่ตรวจสอบสภาพแวดล้อม
ชั้นล่างสุดเรียกว่าเครื่องติดตามการเคลื่อนไหว ทำหน้าที่แปลงแผนเป็นคำสั่งข้อต่อ 50 ครั้งต่อวินาที โดยผสานภาพความลึกเข้ากับข้อมูลตำแหน่งและการเคลื่อนไหวของตัวหุ่นยนต์เอง ช่วยให้ทำตามแผนพร้อมคำนึงถึงสมดุล การสัมผัส และข้อจำกัดของมอเตอร์
Mac mini ติดตั้งอยู่บน G1
ชุดอุปกรณ์จริงติดตั้ง Mac mini ที่ใช้ชิป M4 Pro และหน่วยความจำรวม 64 GB ไว้ในกล่องป้องกันบนหลังของ G1 คอมพิวเตอร์เครื่องนี้ประมวลผลโมเดลวางแผนภารกิจและสร้างการเคลื่อนไหวที่ต้องใช้ทรัพยากรมากกว่า ส่วนตัวประมวลผลที่ติดตั้งมากับ G1 ทำงานเครื่องติดตามการเคลื่อนไหว
ขายึดที่ศีรษะซึ่งออกแบบขึ้นเองติดตั้งกล้อง OAK-1W ไว้ กล้องบันทึกวิดีโอสีที่ความละเอียด 1280 x 800 พิกเซล อัตรา 30 เฟรมต่อวินาที และมุมมอง 120 องศา มุมมองที่กว้างช่วยให้ระบบสังเกตเฟอร์นิเจอร์และช่องทางผ่านที่อยู่ใกล้ขณะร่างกายเคลื่อนที่
หุ่นยนต์ทำงานโดยไม่ต้องเชื่อมต่อสาย ส่วนประกอบซอฟต์แวร์สื่อสารกันผ่าน ZeroMQ ซึ่งเป็นระบบส่งข้อความ การตั้งค่าทำงานในเครื่องตามค่าเริ่มต้นได้โดยไม่ต้องเชื่อมต่ออินเทอร์เน็ต นอกจากนี้ HALO ยังเรียกใช้โมเดลคลาวด์ผ่านอินเทอร์เฟซการเขียนโปรแกรมแอปพลิเคชันได้ หากตั้งค่าไว้
การแบ่งงานประมวลผลสอดคล้องกับลำดับชั้นการควบคุม การทำความเข้าใจคำสั่งอาจเกิดขึ้นไม่บ่อยนัก แต่การรักษาเสถียรภาพของหุ่นยนต์ที่กำลังเคลื่อนไหวต้องอัปเดตให้เร็วกว่า เครื่องสร้างการเคลื่อนไหวคำนวณแผนใหม่ ขณะที่เครื่องติดตามยังคงทำตามแผนปัจจุบัน จึงไม่ต้องหยุดทุกครั้งที่โมเดลต้องประมวลผล
บ้านเสมือน 1,000 หลังใช้สร้างตัวอย่างฝึกอย่างไร
กระบวนการฝึกของ HALO มุ่งแก้ปัญหาการขาดแคลนข้อมูลเฉพาะด้าน ได้แก่ ตัวอย่างที่เชื่อมสิ่งที่หุ่นยนต์ฮิวแมนนอยด์มองเห็น สิ่งที่ได้รับคำสั่ง และวิธีเคลื่อนไหวทั้งร่างกาย วิดีโอทั่วไปมีภาพการกระทำต่าง ๆ แต่การฝึกระบบนี้ต้องจับคู่ภาพเหล่านั้นกับคำสั่งและรายละเอียดการเคลื่อนไหวของหุ่นยนต์
ผู้เขียนอธิบายเวลาที่ต้องใช้กับวิธีบางแบบซึ่งเก็บข้อมูลสาธิตผ่านการควบคุมโดยมนุษย์หรืออุปกรณ์บันทึกที่สวมใส่:
เนื่องจากคนต้องลงมือทำทุกตอนด้วยตนเอง การเก็บข้อมูลหนึ่งชั่วโมงจึงต้องใช้เวลาอย่างน้อยหนึ่งชั่วโมงของมนุษย์
HALO สร้างตัวอย่างที่จับคู่กันในระบบจำลองแทน กระบวนการเริ่มจากแบ่งภารกิจออกเป็นช่วงการเคลื่อนไหว ตัวอย่างเช่น การนั่งบนเก้าอี้มีที่วางแขนอาจประกอบด้วยการเดินไปข้างหน้า หมุนตัว และหย่อนตัวลงนั่ง จากนั้นใช้คำสั่งข้อความ จุดกำหนดเส้นทาง และท่าทางสำคัญเป็นแนวทางให้โมเดลสร้างการเคลื่อนไหวชื่อ Kimodo
ระบบตรวจสอบเรขาคณิตแบบอัตโนมัติจะให้คะแนนการเคลื่อนไหวที่สร้างขึ้นตามปัญหาต่าง ๆ เช่น เท้าไถล ร่างกายทะลุพื้น การกระโดดฉับพลัน และข้อต่อเคลื่อนไหวเกินขีดจำกัด จากนั้นกระบวนการจะเก็บตัวเลือกที่ได้คะแนนดีที่สุดก่อนนำการเคลื่อนไหวไปวางในห้องเสมือน
Infinigen ซึ่งเป็นเครื่องมือสร้างฉากแบบกำหนดขั้นตอน สร้างสภาพแวดล้อม 1,000 รูปแบบที่มีผังและเฟอร์นิเจอร์หลากหลาย ทั้งห้องนั่งเล่น สำนักงาน และห้องนอน ระบบค้นหาตำแหน่งที่การเคลื่อนไหวตามแผนของหุ่นยนต์และวัตถุเป้าหมายอยู่ร่วมกันได้โดยไม่ชนเฟอร์นิเจอร์รอบข้าง
จากนั้นเครื่องจำลองจะสร้างภาพที่หุ่นยนต์จะมองเห็นขณะทำภารกิจ โดยใช้กล้องฟิชอายจำลองที่ปรับให้ตรงกับชุดอุปกรณ์จริง การเปลี่ยนแสง การรับแสง สี คอนทราสต์ ภาพเบลอ และสัญญาณรบกวนจากเซ็นเซอร์ช่วยเพิ่มความหลากหลายให้ภาพ ตัวอย่างแต่ละรายการที่ได้จะเชื่อมคำสั่ง ภาพจากกล้อง และการเคลื่อนไหวของร่างกายที่สอดคล้องกัน
ต้นทุนการประมวลผลและงานของมนุษย์
การสร้างชุดข้อมูลฝึกหลักใช้เวลาราว 48 ชั่วโมง โดยใช้หน่วยประมวลผลกราฟิก Nvidia H100 จำนวน 250 ตัว หน่วยประมวลผลเหล่านี้ซึ่งมักเรียกว่า GPU สามารถคำนวณหลายรายการพร้อมกัน จึงสร้างข้อมูลจำลองปริมาณมากได้ในคราวเดียว
โมเดลสร้างการกระทำได้รับการฝึกด้วยการเรียนรู้เลียนแบบ โดยใช้ GPU Nvidia B200 จำนวน 64 ตัว ในการเรียนรู้เลียนแบบ โมเดลเรียนรู้ที่จะทำซ้ำพฤติกรรมจากตัวอย่าง ส่วนเครื่องติดตามการเคลื่อนไหวฝึกด้วย GPU H100 จำนวน 4 ตัว โดยผสานการเรียนรู้แบบเสริมกำลังเข้ากับการกลั่นนโยบาย
การเรียนรู้แบบเสริมกำลังฝึกตัวควบคุมผ่านการลองทำและรับผลตอบกลับเกี่ยวกับประสิทธิภาพ ส่วนการกลั่นนโยบายถ่ายทอดพฤติกรรมที่เรียนรู้ไปยังอีกโมเดลหนึ่ง ใน HALO วิธีเหล่านี้ช่วยให้เครื่องติดตามแปลงท่าทางตามแผนเป็นการเคลื่อนไหวที่หุ่นยนต์จริงทำได้
มนุษย์ยังคงเป็นผู้กำหนดกระบวนการบางส่วน การเพิ่มภารกิจทางกายภาพใหม่ต้องเขียนคำสั่งและออกแบบท่าทางสำคัญ ส่วนการเคลื่อนไหวบางอย่างอาศัยวิดีโอของมนุษย์หรือข้อมูลจับการเคลื่อนไหว เมื่อมีคำอธิบายภารกิจและข้อจำกัดแล้ว กระบวนการนี้นำไปใช้ซ้ำกับห้องที่สร้างขึ้นได้หลายรูปแบบ
ดังนั้น สิ่งที่เปลี่ยนไปคือวิธีขยายจำนวนตัวอย่างสาธิต แทนที่จะต้องให้คนลงมือทำทุกตอน HALO ใช้ทรัพยากรคอมพิวเตอร์สร้างและตรวจสอบรูปแบบต่าง ๆ ของภารกิจจำนวนมาก
การมองเห็นยังแก้ปัญหาเรื่องการสัมผัสไม่ได้
นักวิจัยระบุว่า ปัจจุบัน HALO พึ่งพาการมองเห็นเป็นหลักและไม่สามารถรับรู้การสัมผัสได้โดยตรง ประสิทธิภาพอาจลดลงในภารกิจที่ต้องสัมผัสวัตถุมาก เมื่อวัตถุหลุดจากมุมกล้องหรือถูกสิ่งอื่นบัง
การดันกล่องแสดงให้เห็นว่าเหตุใดเรื่องนี้จึงสำคัญ หุ่นยนต์ต้องรักษาตำแหน่งร่างกายให้เหมาะสมเมื่อเทียบกับกล่องขณะที่ทั้งคู่เคลื่อนที่ กล้องให้ข้อมูลเกี่ยวกับตำแหน่งที่มองเห็นได้ ส่วนการรับรู้สัมผัสอาจให้ข้อมูลเกี่ยวกับการสัมผัสที่ยังใช้ประโยชน์ได้แม้มุมมองถูกบดบัง
นักวิจัยระบุว่าการรับรู้สัมผัสเป็นแนวทางหนึ่งที่อาจนำไปศึกษาต่อ แต่ไม่ได้ให้กำหนดเวลาว่าจะเพิ่มระบบดังกล่าวเมื่อใด ผลการทดลองปัจจุบันแสดงขอบเขตของความท้าทายไว้อย่างชัดเจนว่า HALO ทำทักษะที่อาศัยการมองเห็นได้หลายอย่างในห้องที่ไม่คุ้นเคย แต่การทำงานต่อเนื่องหลายขั้นตอนและปฏิสัมพันธ์ที่เกี่ยวข้องกับการสัมผัสยังมีความน่าเชื่อถือน้อยกว่า
งานวิจัยนี้เปลี่ยนแปลงอะไร
งานศึกษาของ Apple นำการสร้างข้อมูลฝึก การวางแผนด้วยภาษา และการควบคุมทางกายภาพมารวมไว้ในระบบเดียว ซึ่งทำงานบนหุ่นยนต์ฮิวแมนนอยด์ในห้องที่ไม่เคยพบมาก่อน ผลลัพธ์ที่โดดเด่นที่สุดคือการถ่ายโอนจากสภาพแวดล้อมจำลอง 1,000 รูปแบบไปสู่การทดลองจริง 360 ครั้ง โดยไม่ต้องทำแผนที่สถานที่ทดสอบทั้ง 6 แห่งไว้ล่วงหน้า
โค้ดที่เผยแพร่เปิดให้ศึกษากระบวนการนี้ต่อได้ทั้งในการจำลองและบนฮาร์ดแวร์ ขอบเขตของโค้ดครอบคลุมทั้งเครื่องมือสร้างตัวอย่างฝึก ตลอดจนโมเดลและซอฟต์แวร์ที่จำเป็นต่อการสร้าง ติดตาม และประสานการเคลื่อนไหว
สำหรับคนที่สั่งให้หุ่นยนต์นั่งหรือเคลื่อนย้ายกล่อง ความน่าเชื่อถือขึ้นอยู่กับการทำงานร่วมกันของกระบวนการทั้งหมด ตั้งแต่การระบุวัตถุที่ถูกต้อง การเดินไปถึง การสัมผัสวัตถุ ไปจนถึงการเคลื่อนไหวให้เสร็จสมบูรณ์ ผลการทดสอบภารกิจเดี่ยวของ HALO แสดงถึงความคืบหน้าในกระบวนการนี้ ส่วนผลการทดสอบแบบลำดับชี้ให้เห็นจุดที่ยังต้องพัฒนาก่อนจะเชื่อมการกระทำหลายอย่างเข้าด้วยกันได้อย่างสม่ำเสมอ
ประเด็นสำคัญ
- นักวิจัยของ Apple ส่งงานวิจัย Perceptive Humanoid Motion from Simulation ให้ arXiv เมื่อวันที่ 4 พฤศจิกายน 2026
- HALO ทำภารกิจเดี่ยวสำเร็จเฉลี่ย 91% จากการทดลอง 360 ครั้ง ในสภาพแวดล้อมจริง 6 แห่งที่ไม่คุ้นเคยและไม่ได้ทำแผนที่ไว้
- การทดสอบภารกิจ 3 ชุดแบบผสมกันมีอัตราความสำเร็จเฉลี่ย 70% จาก 30 ครั้ง ในสภาพแวดล้อมจริงอีกแห่ง
- ระบบผสานการวางแผนภารกิจ การสร้างการเคลื่อนไหว และเครื่องติดตามที่ส่งคำสั่งข้อต่อ 50 ครั้งต่อวินาที
- การฝึกใช้ตัวอย่างสังเคราะห์ราว 300 ชั่วโมงในสภาพแวดล้อมที่สร้างขึ้น 1,000 รูปแบบ
- Mac mini ที่ติดตั้งบน Unitree G1 รองรับการทำงานในเครื่องโดยไม่ต้องเชื่อมต่ออินเทอร์เน็ต
- การออกแบบภารกิจโดยมนุษย์ยังเป็นส่วนหนึ่งของการฝึก และการรับรู้การสัมผัสที่จำกัดยังเป็นจุดอ่อน