ผู้ผลิตโทรศัพท์ที่เพิ่งเปลี่ยนโฉมการประมวลผล AI
เช้าวันจันทร์ที่ทำให้วงการเทคโนโลยีประหลาดใจ Xiaomi ทำสิ่งที่ผู้สังเกตการณ์ไม่กี่คนคาดคิด บริษัทซึ่งเป็นที่รู้จักมากที่สุดจากสมาร์ตโฟนราคาย่อมเยา สกู๊ตเตอร์ไฟฟ้า และเครื่องฟอกอากาศในบ้าน ประกาศว่าทลายกำแพงสำคัญด้านความเร็วของปัญญาประดิษฐ์ได้แล้ว โหมดให้บริการ MiMo-V2.5-Pro-UltraSpeed รุ่นใหม่สร้างโทเค็นได้มากกว่า 1,000 โทเค็นต่อวินาทีบนโมเดลขนาดหนึ่งล้านล้านพารามิเตอร์ และทำความเร็วสูงสุดใกล้ 1,200 โทเค็นในการสาธิตสด นี่ไม่ใช่โมเดลเวอร์ชันลดทอน แต่เป็น MiMo-V2.5-Pro รุ่นเรือธงเต็มรูปแบบ ระบบ AI ระดับแนวหน้าที่ทัดเทียม Claude Opus ในการทดสอบมาตรฐานด้านการเขียนโค้ด
สารบัญ
- ผู้ผลิตโทรศัพท์ที่เพิ่งเปลี่ยนโฉมการประมวลผล AI
- ความเร็ว 1,000 โทเค็นต่อวินาทีหมายถึงอะไร
- Xiaomi แซงหน้าผู้พัฒนาชิปเฉพาะทางรายใหญ่อย่างไร
- สามเทคนิคเบื้องหลัง UltraSpeed
- เหตุใดความเร็วจึงปลดล็อกการใช้งานรูปแบบใหม่ทั้งหมด
- การเข้าถึง ราคา และการเผยแพร่แบบโอเพนซอร์ส
- Xiaomi ก้าวขึ้นเป็นขุมพลังด้าน AI อย่างเงียบ ๆ
- สรุปประเด็นสำคัญ
สิ่งที่ทำให้การประกาศนี้น่าตกใจไม่ใช่แค่ความเร็ว แต่คือฮาร์ดแวร์ที่ทำให้เกิดความเร็วดังกล่าว Xiaomi ทำตัวเลขเหล่านี้ได้ด้วยโหนดมาตรฐานเพียงชุดเดียวที่มี GPU ทั่วไป 8 ตัว ซึ่งเป็นอุปกรณ์แบบที่หาได้จากผู้ให้บริการคลาวด์รายใหญ่ทุกราย ไม่มีชิปที่ออกแบบขึ้นเอง ไม่มีชิปเฉพาะทางขนาดเท่าจานอาหาร มีเพียงนวัตกรรมซอฟต์แวร์ที่ทำงานบนฮาร์ดแวร์ซึ่งนักพัฒนาสามารถเช่าใช้ได้ตั้งแต่คืนนี้
พารามิเตอร์คือน้ำหนักเชิงตัวเลขภายในที่กำหนดว่าโมเดล AI ประมวลผลข้อมูลอย่างไร โมเดลที่มีหนึ่งล้านล้านพารามิเตอร์จึงจดจำรูปแบบที่ซับซ้อนอย่างยิ่งในข้อความและโค้ดได้ ส่วนโทเค็นคือหน่วยย่อยของข้อความที่โมเดลอ่านและเขียน โดยแต่ละโทเค็นมีขนาดประมาณสามในสี่ของหนึ่งคำ การสร้างโทเค็นได้มากกว่า 1,000 โทเค็นต่อวินาทีหมายความว่าสมองขนาดมหึมานี้ทำงานด้วยความเร็วที่ก่อนหน้านี้เชื่อกันว่าเป็นไปไม่ได้หากไม่มีฮาร์ดแวร์เฉพาะทาง
หลายปีที่ผ่านมา การแข่งขันเพื่อเพิ่มความเร็วในการประมวลผล AI ถูกครอบงำโดยสตาร์ตอัปด้านชิปที่มีเงินทุนหนาและออกแบบซิลิคอนขึ้นเอง แต่ Xiaomi เพิ่งพิสูจน์ให้เห็นว่าวิศวกรรมที่ชาญฉลาดบนอุปกรณ์มาตรฐานสามารถแซงหน้าคู่แข่งทั้งหมดได้ ความสำเร็จนี้ทำให้เกิดคำถามตรงไปตรงมาว่า จำเป็นต้องใช้ฮาร์ดแวร์เฉพาะทางราคาแพงหรือไม่ ในเมื่อการปรับแต่งซอฟต์แวร์อย่างชาญฉลาดสามารถให้ผลลัพธ์ที่ดีกว่าบนโครงสร้างพื้นฐานที่เข้าถึงได้ทั่วไป
ความเร็ว 1,000 โทเค็นต่อวินาทีหมายถึงอะไร
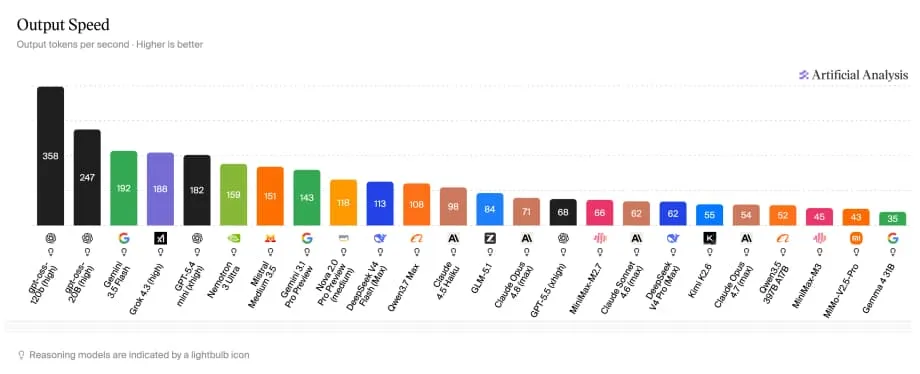
เพื่อเข้าใจว่าตัวเลขนี้สำคัญอย่างไร ลองดูประสบการณ์ที่ผู้ใช้ทั่วไปได้รับในปัจจุบัน ข้อมูลการทดสอบมาตรฐานจาก Artificial Analysis ระบุว่า GPT-5.5 ซึ่งเป็นโมเดลที่ขับเคลื่อนบทสนทนา ChatGPT ส่วนใหญ่ สร้างโทเค็นได้ประมาณ 68 โทเค็นต่อวินาที Claude Opus 4.6 ทำได้ราว 71 โทเค็นต่อวินาที ขณะที่ Haiku ซึ่งเป็นโมเดลขนาดเล็กกว่าของ Anthropic ทำได้ 98 โทเค็น Google Gemini Flash เร็วกว่าที่ 192 โทเค็นต่อวินาที ส่วน MiMo-V2.5-Pro-UltraSpeed ทำได้ 1,000 โทเค็นต่อวินาทีบนโมเดลขนาดหนึ่งล้านล้านพารามิเตอร์ เร็วกว่าแชตบอตที่ผู้คนนับล้านใช้ทุกวันเกือบ 15 เท่า
ช่องว่างระหว่าง 68 กับ 1,000 ไม่ใช่แค่การพัฒนาเพิ่มขึ้นเล็กน้อย แต่เป็นสมรรถนะคนละระดับ ด้วยความเร็วที่ผู้บริโภคใช้อยู่ในขณะนี้ ผู้ใช้ต้องรอหลายวินาทีกว่าข้อความหนึ่งย่อหน้าจะปรากฏ แต่ด้วยความเร็วใหม่ของ Xiaomi บทวิเคราะห์เต็มหนึ่งหน้าสามารถแสดงขึ้นได้แทบจะทันที สำหรับนักพัฒนาที่ใช้เอเจนต์เขียนโค้ด ความแตกต่างนี้เปลี่ยนประสบการณ์จากการโต้ตอบแบบมีช่วงรอให้กลายเป็นการทำงานร่วมกันที่ใกล้เคียงเรียลไทม์
โทเค็นเป็นหน่วยพื้นฐานของโมเดลภาษาขนาดใหญ่ เมื่อคุณพิมพ์คำสั่ง โมเดลจะแบ่งข้อความออกเป็นโทเค็นเพื่อประมวลผล เมื่อโมเดลตอบกลับ ก็จะสร้างโทเค็นทีละตัว โดยคาดการณ์แต่ละตัวจากข้อมูลทั้งหมดที่มาก่อนหน้า ยิ่งโมเดลสร้างโทเค็นได้เร็ว ก็ยิ่งตอบสนองได้ฉับไวและทำงานได้มากขึ้นภายในเวลาที่จำกัด ความเร็วยังกำหนดจำนวนคำขอที่เซิร์ฟเวอร์รองรับได้พร้อมกัน ซึ่งส่งผลโดยตรงต่อต้นทุนและการขยายระบบสำหรับธุรกิจ
โมเดล Flash รุ่นก่อนหน้าของ MiMo-V2.5-Pro สร้างคำตอบได้ 150 โทเค็นต่อวินาที หรือประมาณ 110 คำต่อวินาที ซึ่งเร็วกว่าความเร็วสูงสุดที่มนุษย์อ่านหรือพูดได้ UltraSpeed ดันขีดจำกัดนี้ให้สูงขึ้นอย่างมาก จนสร้างข้อความได้เร็วกว่าความสามารถในการรับรู้ของมนุษย์ และรองรับเวิร์กโฟลว์ที่ขับเคลื่อนด้วยเครื่องจักรซึ่งก่อนหน้านี้เป็นไปไม่ได้
Xiaomi แซงหน้าผู้พัฒนาชิปเฉพาะทางรายใหญ่อย่างไร
คอขวดด้านความเร็วในการประมวลผล AI ดึงดูดเงินลงทุนหลายร้อยล้านดอลลาร์จากบริษัทที่พัฒนาฮาร์ดแวร์เฉพาะทาง Cerebras ออกแบบชิปขนาดเวเฟอร์ที่มีขนาดราวจานอาหาร บรรจุหน่วยความจำบนชิป 44GB เพื่อขจัดข้อจำกัดด้านแบนด์วิดท์ การออกแบบดังกล่าวทำความเร็วได้ 969 โทเค็นต่อวินาที ซึ่งเป็นความสำเร็จที่น่าประทับใจ แต่ทดสอบบน Llama 3.1 405B ของ Meta ซึ่งมี 405 พันล้านพารามิเตอร์ หรือมีขนาดไม่ถึงครึ่งของ MiMo-V2.5-Pro ส่วน Groq สร้างสถาปัตยกรรมหน่วยประมวลผลภาษาที่ออกแบบขึ้นเอง ซึ่งทำความเร็วได้ 300 ถึง 750 โทเค็นต่อวินาที ขึ้นอยู่กับโมเดล ทั้งสองระบบไม่ได้ทำงานบนฮาร์ดแวร์คลาวด์มาตรฐานที่นักพัฒนาสามารถเช่าจากผู้ให้บริการอย่าง AWS ได้
แนวทางของ Xiaomi กลับด้านรูปแบบดังกล่าวโดยสิ้นเชิง บริษัททำสถิติได้โดยร่วมมือกับ TileRT ซึ่งเป็นพันธมิตรด้านการประมวลผล ผ่านแนวทางที่เรียกว่า extreme model system codesign หรือการปรับแต่งร่วมกันอย่างเข้มข้นระหว่างโมเดล AI กับซอฟต์แวร์ที่ให้บริการโมเดล ผลลัพธ์คือโมเดลหนึ่งล้านล้านพารามิเตอร์ที่ทำงานบน GPU ทั่วไปได้เร็วกว่าซิลิคอนเฉพาะทาง หากการทดสอบโดยอิสระยืนยันผลการทดสอบมาตรฐานนี้ ความสำเร็จดังกล่าวชี้ให้เห็นว่านวัตกรรมซอฟต์แวร์สามารถก้าวข้ามข้อจำกัดของฮาร์ดแวร์ที่หลายฝ่ายเชื่อว่าจำเป็นต้องแก้ด้วยชิปที่ออกแบบขึ้นเอง
พัฒนาการนี้มีนัยสำคัญทางเศรษฐกิจ การพัฒนาซิลิคอนเฉพาะทางต้องใช้เงินลงทุนจำนวนมหาศาล วงจรการออกแบบที่ยาวนาน และกระบวนการผลิตเฉพาะทาง ขณะที่ GPU ทั่วไปได้ประโยชน์จากการผลิตในปริมาณมาก การมีจำหน่ายอย่างแพร่หลาย และการปรับปรุงอย่างต่อเนื่องจาก NVIDIA และผู้ผลิตรายอื่น การแก้ปัญหาการประมวลผลด้วยซอฟต์แวร์อาจทำให้ Xiaomi เปิดโอกาสให้ผู้คนเข้าถึงความเร็วระดับที่ก่อนหน้านี้มีเพียงห้องปฏิบัติการที่มีเงินทุนหนาและฮาร์ดแวร์กรรมสิทธิ์เท่านั้นที่ใช้ได้
การเผยแพร่เช็กพอยต์ FP4-DFlash บน Hugging Face ยังช่วยขยายการเข้าถึงในอีกมิติหนึ่ง นักวิจัยและนักพัฒนาทั่วโลกสามารถตรวจสอบ ทดสอบ และปรับใช้โมเดลพื้นฐานได้โดยไม่ต้องซื้อฮาร์ดแวร์กรรมสิทธิ์หรือขอใบอนุญาตระดับองค์กร การตรวจสอบจากชุมชนจะเป็นตัวตัดสินว่าเทคนิคเหล่านี้นำไปใช้ได้อย่างกว้างขวางกับโมเดลและกรณีใช้งานอื่นหรือไม่
สามเทคนิคเบื้องหลัง UltraSpeed
ความก้าวหน้าครั้งนี้อาศัยสามเทคนิคที่ทำงานประสานกัน ไม่มีเทคนิคใดสร้างสถิติความเร็วได้เพียงลำพัง แต่เมื่อนำมารวมกันก็ผลักสมรรถนะให้เกินหลัก 1,000 โทเค็น
เทคนิคแรกคือการควอนไทซ์ FP4 โมเดลขนาดใหญ่ส่วนใหญ่ทำงานด้วยความแม่นยำเชิงตัวเลข 16 บิตหรือ 8 บิต หมายความว่าพารามิเตอร์แต่ละตัวใช้หน่วยความจำสองไบต์หรือหนึ่งไบต์ Xiaomi บีบอัดชั้นผู้เชี่ยวชาญ ซึ่งเป็นส่วนใหญ่ของพารามิเตอร์หนึ่งล้านล้านตัว ให้เหลือความแม่นยำ 4 บิต วิธีนี้ลดขนาดพื้นที่หน่วยความจำและแรงกดดันต่อแบนด์วิดท์ ทำให้ข้อมูลเคลื่อนผ่านระบบได้เร็วขึ้น ความเสี่ยงของการควอนไทซ์คือคุณภาพที่ลดลง เพราะความแม่นยำที่ต่ำลงอาจบั่นทอนความสามารถในการให้เหตุผลของโมเดล Xiaomi แก้ปัญหานี้ด้วยการบีบอัดอย่างเจาะจง เฉพาะชั้นผู้เชี่ยวชาญเท่านั้นที่ถูกบีบอัด ขณะที่ส่วนที่เหลือของโมเดลยังคงความแม่นยำเต็มรูปแบบ บริษัทระบุว่าคุณภาพที่ลดลงจากวิธีนี้แทบเป็นศูนย์
เทคนิคที่สองคือการถอดรหัสแบบคาดการณ์ล่วงหน้า DFlash วิธีถอดรหัสแบบคาดการณ์ล่วงหน้าแบบดั้งเดิมใช้โมเดลร่างที่มีขนาดเล็กกว่าเพื่อเดาโทเค็นถัดไปอย่างรวดเร็ว จากนั้นให้โมเดลขนาดใหญ่ตรวจสอบคำเดาเหล่านั้นพร้อมกัน DFlash ตัดขั้นตอนการร่างแบบต่อเนื่องออกไปทั้งหมด แต่เติมตำแหน่งที่ถูกปิดบังทั้งบล็อกในการส่งผ่านไปข้างหน้าเพียงครั้งเดียว ในงานเขียนโค้ด โมเดลขนาดใหญ่ยอมรับโทเค็นที่เสนอมาเฉลี่ย 6.3 จาก 8 โทเค็นในแต่ละรอบการตรวจสอบ หมายความว่ามีโทเค็นเดินหน้าได้หกตัวในหนึ่งขั้นแทนที่จะเป็นหนึ่งตัว ช่วยเร่งความเร็วในการสร้างข้อความอย่างมหาศาล
องค์ประกอบที่สามคือ TileRT ซึ่งเป็นเอนจินประมวลผลที่ทำให้ไปป์ไลน์การคำนวณทั้งหมดอยู่ใน GPU อย่างต่อเนื่อง ระบบให้บริการมาตรฐานมักเรียกใช้ตัวดำเนินการแต่ละตัวทีละรายการ ทำให้เกิดช่วงว่างเล็ก ๆ ระหว่างการทำงาน TileRT ขจัดเวลาสูญเปล่าจากการเรียกใช้ตัวดำเนินการแต่ละตัว และทำให้ข้อมูลไหลต่อเนื่องไม่สะดุด เมื่อทำงานร่วมกับน้ำหนักโมเดลที่ถูกบีบอัดและกลยุทธ์การถอดรหัสขั้นสูง เอนจินนี้จึงรักษาระดับอัตราประมวลผลที่ก่อนหน้านี้ไม่อาจทำได้บนฮาร์ดแวร์มาตรฐาน
Xiaomi เรียกการผสานเทคนิคเหล่านี้ว่า extreme model system codesign และคำอธิบายนี้ก็ตรงตามความเป็นจริง การปรับแต่งแต่ละชั้นช่วยเสริมประสิทธิภาพซึ่งกันและกัน จนได้ผลลัพธ์โดยรวมที่เหนือกว่าสิ่งที่เทคนิคใดเทคนิคหนึ่งจะทำได้โดยลำพัง
เหตุใดความเร็วจึงปลดล็อกการใช้งานรูปแบบใหม่ทั้งหมด
ตัวเลขการทดสอบดิบไม่มีความหมาย หากไม่ทำให้เกิดสิ่งใหม่ ด้วยความเร็ว 1,000 โทเค็นต่อวินาที MiMo-V2.5-Pro-UltraSpeed เปิดทางสู่การใช้งานที่ระบบช้ากว่ายังทำไม่ได้
ลองพิจารณาวิธีที่นักพัฒนาใช้โมเดลภาษาขนาดใหญ่ทำงานที่ซับซ้อนอยู่ในปัจจุบัน เมื่อเจอปัญหาการเขียนโค้ดที่ยาก ผู้ใช้มักรอคำตอบหนึ่งชุดและหวังว่าจะถูกต้อง แต่เมื่อใช้ UltraSpeed ผู้ใช้คนเดิมสามารถเรียกใช้แนวทางการให้เหตุผลหลายสิบแบบพร้อมกันภายในช่วงเวลาเรียลไทม์เดียวกัน พร้อมตรวจสอบและแก้ไขตัวเองโดยอัตโนมัติอยู่เบื้องหลัง โมเดลสามารถสำรวจวิธีแก้ปัญหาหลายแบบพร้อมกัน แทนที่จะยึดติดกับลำดับความคิดเพียงแนวทางเดียว ความสามารถนี้เปลี่ยน AI จากผู้ช่วยที่ทำงานเป็นลำดับขั้นให้กลายเป็นเครื่องมือแก้ปัญหาแบบขนานอย่างสิ้นเชิง
อุตสาหกรรมที่มีข้อจำกัดด้านเวลาแฝงอย่างเข้มงวดจะได้ประโยชน์ทันที ระบบตรวจจับการฉ้อโกงต้องประเมินธุรกรรมภายในเวลาไม่กี่มิลลิวินาที การสร้างสัญญาณซื้อขายแบบเรียลไทม์ไม่อาจยอมรับความล่าช้าหลายวินาทีได้ ส่วนวงจรการทำงานของเอเจนต์อัตโนมัติ ซึ่งระบบ AI สังเกต ตัดสินใจ และลงมือทำอย่างรวดเร็ว ก็ต้องการความเร็วที่แชตบอตสำหรับผู้บริโภคยังทำไม่ได้ เมื่อทำได้ 68 โทเค็นต่อวินาที แอปพลิเคชันเหล่านี้ต้องเผชิญกับคอขวดที่น่าหงุดหงิด แต่เมื่อทำได้ 1,000 โทเค็นต่อวินาที ก็สามารถใช้งานได้จริงบนโครงสร้างพื้นฐานคลาวด์มาตรฐาน
แม้แต่ในเวิร์กโฟลว์เขียนโค้ดทั่วไป ความเร็วก็เปลี่ยนประสบการณ์ของผู้ใช้ ก่อนหน้านี้นักพัฒนาต้องจ้องหน้าจอระหว่างรอการประมวลผล เมื่อความเร็วส่งผลลัพธ์เข้าใกล้และเกิน 1,000 โทเค็นต่อวินาที ช่วงรอก็แทบหายไป การใช้งานเปลี่ยนจากการส่งคำขอแล้วรอ เป็นการทำงานร่วมกับ AI อย่างแท้จริงแบบเรียลไทม์ ทั้งแอปพลิเคชันด้านสุขภาพที่ต้องวิเคราะห์ข้อมูลผู้ป่วยอย่างรวดเร็ว และแพลตฟอร์มการลงทุนที่ประมวลผลข้อมูลตลาดสด ต่างได้รับประโยชน์ในการใช้งานจริงทันทีจากการตอบสนองระดับนี้
การเข้าถึง ราคา และการเผยแพร่แบบโอเพนซอร์ส
Xiaomi ไม่ได้เก็บเทคโนโลยีนี้ไว้หลังประตูที่ล็อก บริษัทเปิดทดลองใช้ API แบบจำกัด ตั้งแต่วันที่ 9 มิถุนายน ถึง 23 มิถุนายน 2026 การเข้าถึงต้องยื่นใบสมัครและไม่รับประกันว่าจะได้รับอนุมัติ โดยให้ความสำคัญกับผู้ใช้ระดับองค์กรและนักพัฒนามืออาชีพที่มีความต้องการทางธุรกิจชัดเจน เนื่องจากทรัพยากรประมวลผลความเร็วสูงมีจำกัด แต่ละบัญชีเข้าคิวได้สูงสุดวันละ 10 ครั้ง โดยแต่ละช่วงใช้งานจำกัดไว้ที่ 30 นาที หากไม่มีการใช้งานเกิน 5 นาที ระบบจะยกเลิกช่วงใช้งานนั้นโดยอัตโนมัติ
โครงสร้างราคาสะท้อนให้เห็นว่าเทคโนโลยีนี้มีความเร็วระดับพรีเมียม UltraSpeed มีราคาเป็นสามเท่าของอัตราปกติสำหรับ MiMo-V2.5-Pro แต่สร้างข้อความได้เร็วขึ้นประมาณ 10 เท่า เพื่อให้เห็นภาพ MiMo-V2.5-Pro รุ่นมาตรฐานก็มีราคาต่ำกว่า Claude Opus อย่างมากอยู่แล้ว โดยคิดค่าบริการประมาณ 0.43 ดอลลาร์ต่อโทเค็นขาเข้า 1 ล้านโทเค็น และ 0.87 ดอลลาร์ต่อโทเค็นขาออก 1 ล้านโทเค็น เทียบกับ Opus ที่คิด 5 ดอลลาร์สำหรับโทเค็นขาเข้า และ 25 ดอลลาร์สำหรับโทเค็นขาออก ต่อ 1 ล้านโทเค็น แม้คิดราคาเป็นสามเท่า ผลิตภัณฑ์เร่งความเร็วของ Xiaomi ก็ยังมีราคาถูกกว่าโมเดลระดับแนวหน้าคู่แข่งหลายรายมาก
สำหรับนักพัฒนาที่ต้องการทดสอบเทคโนโลยีโดยตรง Xiaomi เผยแพร่เช็กพอยต์ MiMo-V2.5-Pro-FP4-DFlash ซึ่งเป็นโมเดลพื้นฐานแบบโอเพนซอร์สบน Hugging Face แล้ว TileRT ก็เผยแพร่โมดูลบางส่วนบน GitHub เช่นกัน การเคลื่อนไหวนี้เปิดโอกาสให้ชุมชนนักวิจัยทั่วโลกตรวจสอบผลการทดสอบมาตรฐาน ทดลองสถาปัตยกรรม และอาจนำเทคนิคไปปรับใช้กับโมเดลอื่นได้ ขณะนี้ยังไม่มีการเผยแพร่การตรวจสอบยืนยันโดยบุคคลที่สามอย่างแพร่หลาย การทดสอบจากชุมชนผ่านผลงานที่เปิดเผยเหล่านี้จึงจะเป็นบทพิสูจน์ที่แท้จริงในช่วงไม่กี่สัปดาห์ข้างหน้า
Xiaomi ก้าวขึ้นเป็นขุมพลังด้าน AI อย่างเงียบ ๆ
สำหรับผู้บริโภคส่วนใหญ่ Xiaomi ยังคงเป็นแบรนด์ที่จำหน่ายอุปกรณ์อิเล็กทรอนิกส์ราคาย่อมเยา บริษัทขายสมาร์ตโฟน สกู๊ตเตอร์ไฟฟ้า และเครื่องฟอกอากาศไปแล้วหลายล้านเครื่องในตลาดทั่วโลก ภาพลักษณ์ด้านสินค้าอุปโภคบริโภคนี้บดบังแผนกปัญญาประดิษฐ์ที่เติบโตอย่างต่อเนื่อง ซึ่งคนส่วนใหญ่ในอุตสาหกรรมเพิ่งหันมาสนใจในตอนนี้
MiMo-V2.5-Pro ทำคะแนนทัดเทียม Claude Opus ในการทดสอบมาตรฐานด้านการเขียนโค้ดส่วนใหญ่ตั้งแต่เปิดตัวในเดือนเมษายน UltraSpeed ไม่ได้เปิดตัวโมเดลใหม่หรือโมเดลที่ลดทอนความสามารถลง แต่เร่งความเร็วของปัญญาประดิษฐ์ระดับแนวหน้ารุ่นเดิม ซึ่งแข่งขันอยู่ในระดับสูงสุดอยู่แล้ว แบรนด์โทรศัพท์จึงสร้างขีดความสามารถด้าน AI ที่ทัดเทียมห้องปฏิบัติการเฉพาะทาง ขณะเดียวกันก็ยังตั้งราคาต่ำกว่าคู่แข่งหลายเท่าตัว
หากคำกล่าวอ้างเรื่องความเร็วผ่านการตรวจสอบโดยอิสระ Xiaomi ก็จะประสบความสำเร็จอย่างโดดเด่นโดยไม่ต้องใช้เงินหลายร้อยล้านดอลลาร์ลงทุนในซิลิคอนเฉพาะทางอย่างที่ Cerebras และ Groq ต้องทำ บริษัทจะแสดงให้เห็นว่าการปรับแต่งซอฟต์แวร์บนฮาร์ดแวร์ทั่วไปสามารถสร้างสมรรถนะระดับแนวหน้าของตลาดได้ ผลลัพธ์ดังกล่าวจะเปลี่ยนสมมติฐานเกี่ยวกับที่มาของขีดความสามารถด้าน AI และผู้เล่นรายใดที่สามารถแข่งขันในระดับแนวหน้า ยักษ์ใหญ่ด้านอุปกรณ์อิเล็กทรอนิกส์สำหรับผู้บริโภคจากปักกิ่งก้าวเข้าสู่กลุ่มผู้นำนวัตกรรมโครงสร้างพื้นฐาน AI พร้อม GPU มาตรฐานแทนที่จะเป็นซิลิคอนที่ออกแบบขึ้นเอง
สรุปประเด็นสำคัญ
- MiMo-V2.5-Pro-UltraSpeed ของ Xiaomi สร้างได้มากกว่า 1,000 โทเค็นต่อวินาทีบนโมเดลหนึ่งล้านล้านพารามิเตอร์ โดยใช้ GPU ทั่วไปมาตรฐานเพียง 8 ตัว และไม่ต้องใช้ซิลิคอนที่ออกแบบขึ้นเอง
- ความเร็วสูงกว่า GPT-5.5 และ Claude Opus ราว 15 เท่า โดยอาศัยการควอนไทซ์ FP4 การถอดรหัสแบบคาดการณ์ล่วงหน้า DFlash และเอนจินประมวลผล TileRT
- การทดลองใช้ API แบบจำกัดเปิดให้ใช้งานตั้งแต่วันที่ 9 ถึง 23 มิถุนายน 2026 โดยคิดราคาเป็นสามเท่าของอัตรา MiMo มาตรฐาน แลกกับความเร็วในการสร้างข้อความที่สูงขึ้นประมาณ 10 เท่า และให้ความสำคัญกับนักพัฒนาระดับองค์กรและมืออาชีพ
- Xiaomi เผยแพร่เช็กพอยต์ FP4-DFlash เป็นโอเพนซอร์สบน Hugging Face เพื่อให้ชุมชนตรวจสอบและปรับใช้เทคนิคเหล่านี้ได้
- หากมีการตรวจสอบยืนยันโดยอิสระ ความก้าวหน้านี้ชี้ว่าการปรับแต่งซอฟต์แวร์บนฮาร์ดแวร์คลาวด์มาตรฐานสามารถทำได้ดีกว่าโซลูชันชิปเฉพาะทางราคาแพงจากบริษัทฮาร์ดแวร์ AI