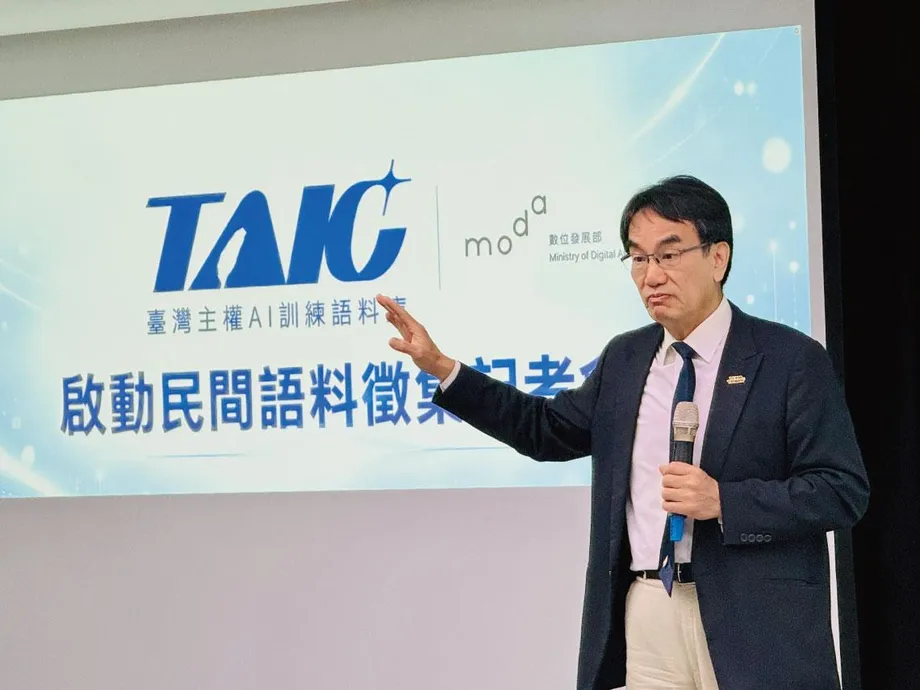
ผลงานจากภาคเอกชน 111 รายการเผยช่องว่างในความมุ่งมั่นด้าน AI ของไต้หวัน
คลังข้อมูลฝึก AI ของรัฐบาลไต้หวันมีข้อมูลสะสม 7,161 รายการ แต่มีเพียง 111 รายการที่มาจากผู้ร่วมให้ข้อมูลภาคเอกชน คิดเป็นราว 1.6% ของทั้งหมด ซึ่งเป็นสัดส่วนเล็กน้อยสำหรับโครงการที่ตั้งใจช่วยให้ปัญญาประดิษฐ์เข้าใจภาษา วัฒนธรรม และชีวิตประจำวันของไต้หวัน
สารบัญ
- ผลงานจากภาคเอกชน 111 รายการเผยช่องว่างในความมุ่งมั่นด้าน AI ของไต้หวัน
- คลังข้อมูลของรัฐบาลมีอะไรบ้าง
- เหตุใดภาษาท้องถิ่นจึงสำคัญ
- การร้องทุกข์ทางอาญาทำให้ต้องทบทวนแนวทาง
- ลิขสิทธิ์เกี่ยวข้องกับการฝึก AI อย่างไร
- การอนุญาตโดยสมัครใจ ไม่ใช่การโอนกรรมสิทธิ์
- มีตัวอย่างความร่วมมือแบบมีค่าตอบแทนแล้ว
- ข้อยกเว้นทางกฎหมายและใบอนุญาตแบบรวมเป็นแนวทางที่แข่งขันกัน
- TAIDE แสดงให้เห็นว่าเหตุใดการเข้าถึงและทรัพยากรจึงสำคัญ
- ประเด็นสำคัญ
กระทรวงกิจการดิจิทัลเปิดตัวคลังข้อมูลฝึก AI อธิปไตยของไต้หวันเมื่อวันที่ 24 ธันวาคม 2025 โดยมีหน่วยงานรัฐบาลกว่า 200 แห่งร่วมส่งชุดข้อมูลมากกว่า 2,000 ชุด ซึ่งมีโทเคนรวม 600 ล้านโทเคน โทเคนคือหน่วยข้อความขนาดเล็กที่ระบบ AI นำไปประมวลผล บางครั้งเป็นอักขระหนึ่งตัว บางครั้งเป็นส่วนหนึ่งของคำ
การมีส่วนร่วมของภาครัฐช่วยให้โครงการขยายขนาดได้ แต่การดึงสำนักพิมพ์ นักเขียน แพลตฟอร์มการสอน และองค์กรข่าวเข้ามาร่วมเป็นโจทย์ที่ยากกว่า นักพัฒนาต้องได้รับอนุญาตให้คัดลอกงานเขียนที่มีคุณค่าสำหรับใช้ฝึก AI ขณะที่เจ้าของเนื้อหาต้องการค่าตอบแทนและควบคุมวิธีนำผลงานไปใช้
ในการไต่สวนของฝ่ายนิติบัญญัติเมื่อวันที่ 14 ตุลาคม 2026 หลิน อี้จิง รัฐมนตรีว่าการกระทรวงกิจการดิจิทัล กล่าวว่า การมีส่วนร่วมของภาคเอกชนเป็นไปโดยสมัครใจ และรัฐบาลต้องการให้บริษัท AI รายใหญ่ โดยเฉพาะบริษัทอเมริกัน จ่ายเงินสำหรับเนื้อหาที่ใช้ฝึก AI ส่วนเนื้อหาข่าวยังไม่อยู่ในโครงการรวบรวมข้อมูลจากภาคเอกชนในปัจจุบัน
ประเด็นที่มีผลในทางปฏิบัตินั้นกว้างไกลกว่าขนาดของฐานข้อมูล โมเดลที่ฝึกด้วยงานเขียนของไต้หวันสามารถเรียนรู้คำศัพท์ท้องถิ่น อธิบายประเพณีวัฒนธรรม และตอบคำถามโดยคำนึงถึงสถาบันต่าง ๆ ของไต้หวันได้ อย่างไรก็ตาม นักเขียนและองค์กรที่ผลิตเนื้อหาเหล่านี้ก็พึ่งพามูลค่าทางการค้าของผลงานเช่นกัน ไต้หวันกำลังพยายามขยายการเข้าถึงผลงาน พร้อมตัดสินใจว่าใครควรเป็นผู้จ่ายเงิน การอนุญาตครอบคลุมอะไรบ้าง และกฎลิขสิทธิ์ส่วนใดที่ต้องทำให้ชัดเจน
คลังข้อมูลของรัฐบาลมีอะไรบ้าง
ประกาศเปิดตัวเมื่อเดือนธันวาคมของกระทรวงระบุว่า คลังข้อมูลครอบคลุมภาษา วัฒนธรรม การศึกษา ชีววิทยา และภูมิศาสตร์ โดยรวบรวมข้อมูลเปิดของรัฐบาลที่เผยแพร่มานานกว่าสิบปี และเปิดให้ผู้ใช้ค้นหาและดาวน์โหลดเนื้อหาได้
กระทรวงวัฒนธรรมส่งชุดข้อมูลเกี่ยวกับงานศิลปะสาธารณะและทรัพย์สินทางวัฒนธรรม ส่วนกระทรวงศึกษาธิการส่งข้อมูลพจนานุกรมที่ครอบคลุมภาษาไต้หวัน ภาษาฮากกา และภาษาจีนกลาง ทรัพยากรเหล่านี้ช่วยให้นักพัฒนามีข้อมูลเกี่ยวกับความหมายและการใช้คำในท้องถิ่น ตลอดจนข้อมูลเกี่ยวกับสถานที่ สิ่งของ และประเพณี
รายละเอียดโครงการคลังข้อมูลของกระทรวงยังระบุชื่อสภาชนพื้นเมืองและสภากิจการฮากกาเป็นหน่วยงานที่เข้าร่วมด้วย หัวข้อที่วางแผนไว้ครอบคลุมประวัติศาสตร์ มรดกทางวัฒนธรรม การท่องเที่ยว และวัฒนธรรมท้องถิ่น กระทรวงระบุว่าข้อความที่มีประโยชน์ต่อการฝึก AI ควรต่อเนื่อง ครบถ้วน และลื่นไหล
ตัวเลขเดือนกันยายน 2026 ที่รายงานต่อฝ่ายนิติบัญญัติระบุว่า คลังข้อมูลมีชุดข้อมูลมากกว่า 5,000 ชุด และมีโทเคนกว่า 2.4 พันล้านโทเคน เมื่อเทียบกับ 600 ล้านโทเคนที่ประกาศตอนเปิดตัว เท่ากับมีข้อความเพิ่มขึ้นกว่า 4 เท่าเมื่อวัดเป็นจำนวนโทเคน ส่วนตัวเลข 7,161 รายการและผลงานจากภาคเอกชน 111 รายการก็เป็นภาพสะท้อนอีกด้านขององค์ประกอบในคลังข้อมูล
เหตุใดภาษาท้องถิ่นจึงสำคัญ
อู๋ เชออวี่ ศิลปินสื่อใหม่และผู้ก่อตั้งโครงการองค์ความรู้ชุมชน Taiwan.md มองว่า งานเขียนภาษาจีนตัวเต็มมีสัดส่วนน้อยเกินไปในข้อมูลฝึก AI กระแสหลัก เขาประเมินว่าสัดส่วนของเนื้อหาฝึก AI ภาษาจีนที่เป็นตัวเต็มต่ำกว่า 1% โดยยกตัวเลขนี้ขึ้นมาอธิบายที่มาของโครงการ
สิ่งที่อู๋กังวลไม่ได้จำกัดอยู่แค่การแปลงอักษรตัวย่อเป็นตัวเต็ม ไต้หวันกับจีนใช้คำเรียกสิ่งของในชีวิตประจำวันบางอย่างต่างกัน และสำนวนเดียวกันก็อาจมีความหมายต่างกันได้ องค์ความรู้ท้องถิ่นยังครอบคลุมสถาบัน ประวัติศาสตร์ และอาหาร รวมถึงเมนูที่ได้รับความสนใจจากนานาชาติน้อยกว่าชานมหรือเสี่ยวหลงเปา
Taiwan.md ใช้เครื่องมือ AI รวบรวมข้อมูลจากเว็บและเรียบเรียงบทความเกี่ยวกับธรรมชาติ สังคม และประวัติศาสตร์ของไต้หวัน บทความ 1,123 ชิ้นของโครงการอ้างอิงงานวิชาการ บล็อก และข้อมูลจากรัฐบาลที่เข้าถึงได้สาธารณะ อู๋ต้องการให้โมเดลกระแสหลักอย่าง ChatGPT, Gemini และ Claude เข้าถึงงานเขียนที่สะท้อนประสบการณ์ของชาวไต้หวันมากขึ้น
รัฐบาลอธิบายความมุ่งมั่นที่เกี่ยวข้องนี้ว่าเป็น AI อธิปไตย ซึ่งหมายถึงการพัฒนาทรัพยากรและขีดความสามารถด้าน AI ที่ไต้หวันสามารถกำหนดให้สอดคล้องกับความต้องการของตนเอง คลังข้อมูลของรัฐบาลจัดเตรียมเนื้อหาสำหรับฝึก AI ส่วนโครงการอย่าง Taiwan.md มุ่งทำให้นักพัฒนา AI ค้นพบองค์ความรู้ท้องถิ่นได้ง่ายขึ้น
การร้องทุกข์ทางอาญาทำให้ต้องทบทวนแนวทาง
ในเดือนกรกฎาคม 2025 นักศึกษาปริญญาเอกมหาวิทยาลัยแห่งชาติไต้หวันถูกแจ้งความดำเนินคดีอาญาฐานละเมิดลิขสิทธิ์ หลังเผยแพร่คลังข้อมูลภาษาจีนตัวเต็มที่มีบทความ 140,000 ชิ้นจากสำนักข่าวกลาง (Central News Agency) โดยไม่ได้รับอนุญาต นักศึกษารวบรวมเนื้อหาจากเว็บไซต์อเมริกันที่เผยแพร่ทรัพยากรแบบเปิด และนำคลังข้อมูลดังกล่าวมาแบ่งปันโดยไม่คิดค่าใช้จ่าย
ต่อมาทั้งสองฝ่ายตกลงยุติข้อพิพาท นักศึกษากล่าวขอโทษ เรียกร้องให้นักวิจัยตรวจสอบว่าแหล่งข้อมูลของตนชอบด้วยกฎหมายหรือไม่ และลบคลังข้อมูลทั้งหมด
อู๋กล่าวว่าคดีนี้ทำให้นักพัฒนาอิสระระมัดระวังมากขึ้น ทีม Taiwan.md ของเขาตัดเนื้อหาทิ้งเมื่อพบว่าอาจมีปัญหาลิขสิทธิ์ ส่งผลให้การขยายคลังข้อมูลช้าลง สำหรับโครงการขนาดเล็ก ความเสี่ยงที่จะถูกดำเนินคดีอาญาเพิ่มความเสี่ยงส่วนบุคคลให้กับงานที่ยากอยู่แล้วอย่างการตรวจสอบสิทธิ์การใช้งาน
เหตุการณ์ต่อไปนี้ช่วยอธิบายพัฒนาการของประเด็นดังกล่าว:
- ต้นปี 2023: สภาวิทยาศาสตร์และเทคโนโลยีแห่งชาติเริ่มโครงการโมเดลภาษา TAIDE ด้วยงบประมาณกว่า 200 ล้านดอลลาร์ไต้หวันใหม่
- กรกฎาคม 2025: นักศึกษาปริญญาเอกถูกแจ้งความกรณีคลังข้อมูลที่มีบทความข่าวซึ่งไม่ได้รับอนุญาต
- 24 ธันวาคม 2025: กระทรวงกิจการดิจิทัลประกาศคลังข้อมูล AI อธิปไตย ซึ่งมี 600 ล้านโทเคน
- กันยายน 2026: ตัวเลขจากกระทรวงระบุว่ามีชุดข้อมูลมากกว่า 5,000 ชุด และโทเคนกว่า 2.4 พันล้านโทเคน
- 14 ตุลาคม 2026: รัฐมนตรีหลินแจ้งต่อฝ่ายนิติบัญญัติว่า การส่งข้อมูลจากภาคเอกชนเป็นไปโดยสมัครใจ และการทำข้อตกลงจ่ายเงินสำหรับเนื้อหาเป็นเป้าหมายเชิงนโยบาย
ลิขสิทธิ์เกี่ยวข้องกับการฝึก AI อย่างไร
เฉิน ฉีตง ทนายความอาวุโสจากสำนักงานกฎหมายลู่กั๋ว ระบุว่าการคัดลอกเป็นประเด็นกฎหมายสำคัญ โดยทั่วไปนักพัฒนาต้องทำสำเนาข้อความก่อนนำไปใช้ฝึกโมเดล กฎหมายลิขสิทธิ์ให้เจ้าของสิทธิควบคุมการทำซ้ำผลงาน โดยมีข้อยกเว้นบางประการ เช่น การใช้โดยชอบธรรม
การใช้โดยชอบธรรมอนุญาตให้นำผลงานที่ได้รับความคุ้มครองไปใช้บางลักษณะโดยไม่ต้องขออนุญาต ภายใต้เงื่อนไขเฉพาะ เฉินกล่าวว่าบทบัญญัติที่มีอยู่ของไต้หวันไม่ได้กล่าวถึงการฝึก AI ไว้อย่างชัดเจน ทำให้นักพัฒนาไม่แน่ใจว่าศาลจะยอมรับการใช้งานในลักษณะดังกล่าวหรือไม่
การฝึกโมเดลและการสร้างคำตอบยังเป็นการกระทำคนละขั้นตอน ระหว่างการฝึก ระบบประมวลผลตัวอย่างเพื่อเรียนรู้รูปแบบ ส่วนระหว่างการสร้างคำตอบ ระบบผลิตข้อความให้ผู้ใช้ เฉินเสนอให้กฎหมายกำหนดหลักเกณฑ์สำหรับสองขั้นตอนนี้แยกจากกัน รวมถึงความเสี่ยงที่ผลลัพธ์จะมีเนื้อหาใกล้เคียงกับผลงานที่ได้รับความคุ้มครอง
สำนักงานทรัพย์สินทางปัญญาภายใต้กระทรวงเศรษฐกิจระบุว่า การปรับแก้กฎหมายที่อาจเกิดขึ้นยังอยู่ระหว่างการศึกษา กระทรวงกิจการดิจิทัลระบุว่าสำนักงานดังกล่าวเป็นหน่วยงานรับผิดชอบนโยบายลิขสิทธิ์ นอกจากนี้ การสอบสวนของสภาควบคุมยังเรียกร้องให้เร่งปรับกรอบกฎหมาย หลังสภาบริหารมอบหมายให้สำนักงานดำเนินการเรื่องนี้
การอนุญาตโดยสมัครใจ ไม่ใช่การโอนกรรมสิทธิ์
รัฐมนตรีหลินแจ้งต่อคณะกรรมาธิการคมนาคมของฝ่ายนิติบัญญัติว่า โครงการรวบรวมข้อมูลจากภาคเอกชนเริ่มจากสำนักพิมพ์และแพลตฟอร์มหนังสืออิเล็กทรอนิกส์ เขาระบุว่ารัฐบาลต้องการเนื้อหา 4 ประเภทดังนี้:
- หนังสือที่หมดอายุความคุ้มครองลิขสิทธิ์แล้ว
- คำบรรยายหนังสือที่สำนักพิมพ์จัดทำให้
- ข้อความตัวอย่างบางส่วนจากหนังสือ
- ผลงานที่นักเขียนแต่ละคนอนุญาตให้นำไปใช้โดยสมัครใจ
หลินกล่าวว่ากระทรวงขออนุญาตนำผลงานไปใช้ฝึก AI โดยผู้เขียนยังคงเป็นเจ้าของลิขสิทธิ์ ใบอนุญาตเปิดทางให้อีกฝ่ายดำเนินการบางอย่างตามเงื่อนไขที่ตกลงกันไว้ ขอบเขตของใบอนุญาตอาจครอบคลุมเรื่องต่าง ๆ เช่น การใช้งานที่ได้รับอนุญาตและระยะเวลา
หลิน ฉู่หยิน สมาชิกสภานิติบัญญัติจากพรรคประชาธิปไตยก้าวหน้า ตั้งคำถามว่าผู้ร่วมให้ข้อมูลจะได้รับค่าตอบแทนอย่างไร จะเกิดอะไรขึ้นหากภายหลังพวกเขาถอนการอนุญาต และจะคุ้มครองผลประโยชน์ของผู้ให้ข้อมูลอย่างไรเมื่อการฝึกนำไปสู่ผลิตภัณฑ์อื่น ส่วนหง อวี่เสียง สมาชิกสภานิติบัญญัติจากพรรคประชาชนไต้หวัน เสนอให้มีบริการที่ดูแลการตรวจสอบคุณภาพ การเคลียร์สิทธิ์ การจัดซื้อเนื้อหาแบบมีค่าตอบแทน และการบริหารใบอนุญาตประเภทต่าง ๆ
กระทรวงเผยแพร่ใบอนุญาตคลังข้อมูลฝึก AI อธิปไตยของไต้หวัน ฉบับที่ 1 และร่วมมือกับสำนักงานทรัพย์สินทางปัญญาจัดทำตัวอย่างเพื่อช่วยหน่วยงานต่าง ๆ นำไปใช้ เงื่อนไขมาตรฐานมีเป้าหมายลดการเจรจาซ้ำและข้อพิพาทด้านลิขสิทธิ์ กระทรวงยังวางแผนจัดทำสิ่งจูงใจสำหรับผู้ร่วมให้ข้อมูลด้วย อย่างไรก็ตาม ข้อเสนอที่เปิดเผยต่อสาธารณะยังไม่ได้ข้อยุติเรื่องอัตราค่าตอบแทน การถอนการอนุญาต และหลักเกณฑ์สำหรับผลิตภัณฑ์ที่พัฒนาต่อยอด
มีตัวอย่างความร่วมมือแบบมีค่าตอบแทนแล้ว
หลี่ โปเฟิง ประธานมูลนิธิวัฒนธรรมเปิด กล่าวว่า การขอให้สำนักพิมพ์มอบเนื้อหาที่มีคุณค่าให้โดยไม่คิดค่าใช้จ่ายไม่น่าจะทำให้มีผู้เข้าร่วมมากพอ เขายกตัวอย่างโครงการฝึก AI ขนาดเล็กที่ได้ความร่วมมือจากสื่อและแพลตฟอร์มการศึกษา ผ่านการแลกเปลี่ยนที่เจรจาตกลงกัน
ข้อตกลงกำหนดให้จ่ายค่าใบอนุญาตครั้งเดียว จำกัดระยะเวลาใช้ข้อมูลไว้ที่ 2 ปี และให้ผู้ให้บริการเนื้อหาที่เข้าร่วมเข้าถึงโมเดลที่พัฒนาขึ้นก่อน เงื่อนไขนี้ทำให้ผู้ร่วมให้ข้อมูลได้รับเงิน กำหนดช่วงเวลาใช้งานไว้อย่างชัดเจน และได้รับสิ่งที่เป็นประโยชน์ตอบแทน
หวัง หรงเหวิน ประธานสำนักพิมพ์หยวนหลิ่ว เห็นเช่นกันว่าหน่วยงานรัฐบาลและนักพัฒนาเชิงพาณิชย์ควรจัดสรรงบประมาณสำหรับใบอนุญาตเนื้อหา เขามองว่าความกังวลเรื่องการถูกแจ้งความดำเนินคดีอาญาเป็นข้อจำกัดทั้งต่อนักพัฒนาเอกชนและเจ้าหน้าที่ที่พยายามสนับสนุนโครงการ AI
หลินแจ้งต่อฝ่ายนิติบัญญัติว่า เป้าหมายในท้ายที่สุดของรัฐบาลคือการให้บริษัท AI รายใหญ่จ่ายเงินเพื่อเข้าถึงเนื้อหา เขากล่าวว่าข้อพิพาทด้านลิขสิทธิ์ที่เกี่ยวข้องกับเทคโนโลยีใหม่อาจยืดเยื้อ 3-5 ปี กระทรวงจึงเริ่มจากเนื้อหาที่มีข้อพิพาทน้อยกว่า กรอบเวลาที่เขากล่าวถึงเป็นการประเมินระยะเวลาที่ข้อถกเถียงอาจดำเนินต่อไป ไม่ใช่กำหนดเสร็จสิ้นของกฎหมายหรือระบบการจ่ายเงิน
ข้อยกเว้นทางกฎหมายและใบอนุญาตแบบรวมเป็นแนวทางที่แข่งขันกัน
เฉินเสนอให้เพิ่มหมวด AI โดยเฉพาะในกฎหมายลิขสิทธิ์ของไต้หวัน เพื่อกำหนดข้อยกเว้นสำหรับการทำเหมืองข้อความและข้อมูล บังคับให้เปิดเผยแหล่งข้อมูลฝึก AI และลดความเสี่ยงที่จะถูกดำเนินคดีอาญาสำหรับกิจกรรมที่เข้าเกณฑ์
การทำเหมืองข้อความและข้อมูลหมายถึงการใช้ซอฟต์แวร์วิเคราะห์เนื้อหาจำนวนมากเพื่อค้นหารูปแบบ สหภาพยุโรป ญี่ปุ่น และสิงคโปร์มีข้อยกเว้นสำหรับกิจกรรมลักษณะนี้บางประเภท แม้กฎและเงื่อนไขจะแตกต่างกัน เฉินมองว่าแนวทางเหล่านี้เป็นแบบอย่างสำหรับการอภิปรายในไต้หวัน
หลี่เสนอขั้นตอนด้านการบริหารที่ทำได้ก่อน คือจัดทำแนวทางอธิบายว่าหน่วยงานมองว่าการใช้ข้อมูลฝึก AI แบบใดเข้าข่ายการใช้โดยชอบธรรม และแบบใดเสี่ยงละเมิดลิขสิทธิ์ เขายกตัวอย่างสำนักงานกิจการวัฒนธรรมของญี่ปุ่น พร้อมรายการตรวจสอบและแนวทางด้านลิขสิทธิ์ AI ปี 2024 ซึ่งช่วยอธิบายความคาดหวังให้ทั้งนักพัฒนาและผู้สร้างสรรค์เข้าใจได้จริงมากขึ้น
เฉินยังเสนอระบบใบอนุญาตแบบรวม โดยยกตัวอย่างสมาคมลิขสิทธิ์ดนตรีแห่งสาธารณรัฐจีน หรือ MÜST ในอุตสาหกรรมดนตรี ภายใต้รูปแบบนี้ องค์กรหนึ่งจะจัดการสิทธิ์แทนเจ้าของสิทธิ์หลายราย เรียกเก็บค่าธรรมเนียม และจัดสรรเงินให้ผู้เกี่ยวข้อง สำหรับ AI บริการลักษณะเดียวกันอาจลดภาระการเจรจาแยกกับสำนักพิมพ์หรือนักเขียนหลายร้อยราย
ส่วนจาง จงซิน ผู้ช่วยศาสตราจารย์พิเศษจากสถาบันทรัพย์สินทางปัญญา มหาวิทยาลัยเทคโนโลยีแห่งชาติไทเป มีมุมมองต่างออกไป เขาเห็นว่านักพัฒนาควรจ่ายเงินตามกฎหมายลิขสิทธิ์ที่มีอยู่ แทนการเรียกร้องให้แก้กฎหมาย จุดยืนของเขาให้ความสำคัญกับการเจรจาเพื่อเข้าถึงเนื้อหาสิ่งพิมพ์และข่าวที่มีคุณค่า
TAIDE แสดงให้เห็นว่าเหตุใดการเข้าถึงและทรัพยากรจึงสำคัญ
TAIDE หรือระบบสนทนา AI ที่เชื่อถือได้ของไต้หวัน แสดงให้เห็นว่าโมเดลอาจพึ่งพาคลังข้อมูลที่เข้าถึงได้เพียงไม่กี่แหล่งมากเพียงใด โครงการนี้จัดตั้งขึ้นภายใต้สภาวิทยาศาสตร์และเทคโนโลยีแห่งชาติเมื่อต้นปี 2023 โดยได้รับงบพัฒนาเริ่มต้นกว่า 200 ล้านดอลลาร์ไต้หวันใหม่
TAIDE ใช้เนื้อหาฝึกจากหน่วยงานรัฐบาล 15 แห่ง โดยบทความราว 4 ล้านชิ้นจากสำนักข่าวกลางคิดเป็น 70% ของข้อมูลข้อความ เนื้อหาเหล่านี้ได้มาจากแหล่งที่คำนึงถึงประเด็นลิขสิทธิ์ แสดงให้เห็นว่าการจัดการสิทธิ์เข้าถึงคลังข่าวขนาดใหญ่เป็นระบบสามารถสนับสนุนโมเดลท้องถิ่นได้
ยู่เจี๋ย หลี่ หัวหน้าทีมวิจัยจากศูนย์ความมั่นคงสารสนเทศไต้หวัน สถาบันวิจัยกลาง อธิบายคุณค่าของการมีทางเลือกภายในประเทศไว้ว่า:
ในช่วงแรกเราอาจยังสู้ระบบขนาดใหญ่ไม่ได้ แต่การมีระบบสนทนาของเราเองก็หมายความว่าอย่างน้อยเรายังมีทางเลือก
โมเดลรุ่นแรกสร้างขึ้นบน Llama 2 ของ Meta และมีพารามิเตอร์ 7 พันล้านตัว ซึ่งเป็นค่าตัวเลขที่โมเดลปรับระหว่างการเรียนรู้ ศูนย์คอมพิวเตอร์สมรรถนะสูงแห่งชาติมีหน่วยประมวลผลกราฟิก V100 จำนวน 1,028 ตัว และจัดซื้อหน่วยประมวลผล H100 จำนวน 9 ตัวในเดือนพฤศจิกายน 2023 สำหรับโครงการ โดยยังคงให้บริการตามปกติ
โครงการตอบคำถามด้านการเกษตร Demeter GPT ของมหาวิทยาลัยแห่งชาติจุงซิงเปลี่ยนจาก ChatGPT มาใช้ TAIDE ในเวลาต่อมา ฟ่าน เหยาจง รองศาสตราจารย์ของโครงการกล่าวว่า ความแม่นยำของภาษาจีนดีขึ้นหลังฝึกเพิ่มเติม ก่อนหน้านี้ห้องปฏิบัติการจ่ายเงินให้ OpenAI ครั้งละ 1-2 ดอลลาร์ไต้หวันใหม่ต่อคำตอบ แต่การใช้ TAIDE ในระบบของตนเองทำให้ค่าใช้จ่ายในการดำเนินงานเปลี่ยนเป็นค่าเครื่องคอมพิวเตอร์และไฟฟ้าของห้องปฏิบัติการ
โครงการคลังข้อมูลของไต้หวันมุ่งแก้ปัญหาแหล่งข้อความสำหรับแอปพลิเคชันลักษณะนี้ พจนานุกรมและบันทึกทางวัฒนธรรมของรัฐบาลเป็นรากฐาน ส่วนการเข้าถึงข้อมูลจากสำนักพิมพ์ สื่อการสอนเฉพาะทาง และงานข่าวที่กว้างขึ้นนั้น ขึ้นอยู่กับข้อตกลงที่นักพัฒนาจ่ายไหวและเจ้าของเนื้อหายอมรับได้
ประเด็นสำคัญ
- ผู้ร่วมให้ข้อมูลภาคเอกชนส่งผลงาน 111 รายการจากคลังข้อมูลทั้งหมด 7,161 รายการ หรือราว 1.6%
- รัฐบาลประกาศว่าคลังข้อมูลมี 600 ล้านโทเคนตอนเปิดตัวในเดือนธันวาคม 2025 และมีจำนวนเพิ่มขึ้นเกิน 2.4 พันล้านโทเคนภายในเดือนกันยายน 2026
- รัฐมนตรีหลินระบุว่าการมีส่วนร่วมของภาคเอกชนเป็นไปโดยสมัครใจ และผู้เขียนยังคงเป็นเจ้าของลิขสิทธิ์
- เนื้อหาข่าวยังไม่อยู่ในโครงการรวบรวมข้อมูลจากภาคเอกชนในปัจจุบัน ขณะที่กระทรวงพยายามทำข้อตกลงแบบมีค่าตอบแทนกับบริษัท AI
- การแจ้งความดำเนินคดีอาญาในเดือนกรกฎาคม 2025 กรณีบทความข่าว 140,000 ชิ้นที่ไม่ได้รับอนุญาต ทำให้นักพัฒนาอิสระกังวลมากขึ้น
- ข้อเสนอประกอบด้วยแนวทางการใช้โดยชอบธรรมที่ชัดเจนขึ้น ข้อยกเว้นสำหรับการทำเหมืองข้อมูล การอนุญาตแบบรวม และการจ่ายเงินโดยตรงภายใต้กฎหมายที่มีอยู่