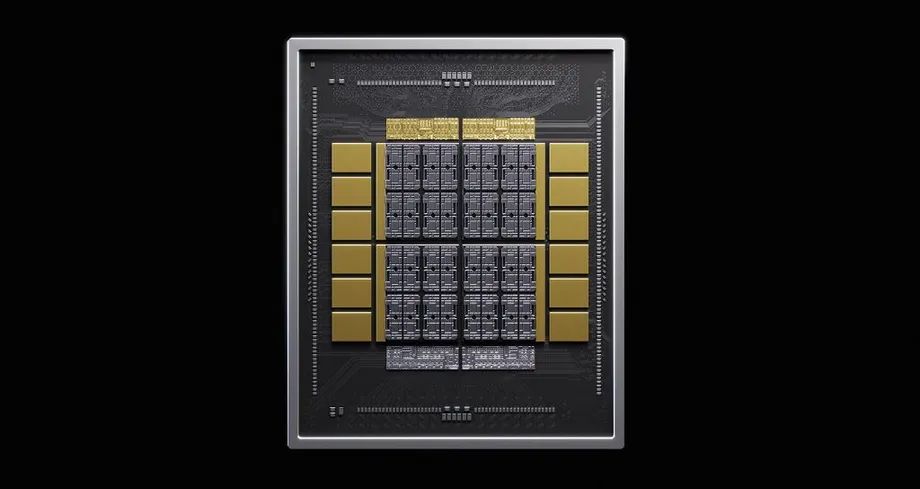
สูตรการผลิตเดียวกันสำหรับผู้ผลิตหน่วยความจำสามราย
รายงานในอุตสาหกรรมที่เผยแพร่เมื่อวันที่ 18 ตุลาคม 2026 ระบุว่า Nvidia ขอให้ Samsung Electronics, SK hynix และ Micron ใช้กระบวนการผลิต 3 นาโนเมตรของ TSMC สำหรับเบสดายในหน่วยความจำแบนด์วิดท์สูงแบบกำหนดเองรุ่นถัดไปของบริษัท มีรายงานว่าฝ่าย Device Solutions ของ Samsung ตอบรับคำขอหลังการทบทวนภายใน ซึ่งทำให้คู่แข่งด้านโรงหล่อในไต้หวันเข้ามามีบทบาทในขั้นตอนหนึ่งของการผลิตหน่วยความจำที่ Samsung เคยดำเนินการเองมาโดยตลอด
สารบัญ
- สูตรการผลิตเดียวกันสำหรับผู้ผลิตหน่วยความจำสามราย
- เกิดอะไรขึ้นภายในชุดหน่วยความจำ?
- เหตุใด Nvidia จึงต้องการกระบวนการเดียวกันจากทุกซัพพลายเออร์
- Samsung ยังคงใช้โรงงานของตัวเอง
- Micron และ SK hynix เลือกแนวทางต่างกัน
- ตัวเลขประสิทธิภาพของ Nvidia หมายถึงอะไร
- Amazon เชื่อมหน่วยความจำเข้ากับแพลตฟอร์มโดยรวมของ Nvidia
- พัฒนาการของการเปลี่ยนแปลง
- ประเด็นสำคัญ
ผลิตภัณฑ์นี้มีชื่อว่า NVHBM และพัฒนาจาก HBM4E ซึ่งเป็นหน่วยความจำแบนด์วิดท์สูงรุ่นที่ 7 นอกจากนี้ Nvidia ยังต้องการให้ซัพพลายเออร์ใช้เทคโนโลยีการผลิต DRAM รุ่นที่ 6 สำหรับดายหน่วยความจำ ซึ่งเรียกว่า 1c เป้าหมายคือทำให้หน่วยความจำจากซัพพลายเออร์แต่ละรายทำงานสอดคล้องกันมากขึ้น และลดงานด้านวิศวกรรมที่จำเป็นต่อการอนุมัติผลิตภัณฑ์ของแต่ละราย
การตัดสินใจของ Samsung จะขยายความร่วมมือที่มีอยู่กับ TSMC จากด้านความเข้ากันได้ของเทคโนโลยีแพ็กเกจจิงไปสู่การผลิต HBM ทั้งสองบริษัทเคยทำงานร่วมกันเมื่อสี่ปีก่อน เพื่อให้แน่ใจว่าหน่วยความจำ Samsung สามารถเชื่อมต่อกับหน่วยประมวลผลกราฟิกผ่านเทคโนโลยีแพ็กเกจจิงของ TSMC ได้ การผลิตชิปสำคัญภายในชุดหน่วยความจำถือเป็นการยกระดับความร่วมมือนี้ขึ้นไปอีกขั้น
ข้อเสนอของ Nvidia ยังเปลี่ยนบทบาทของเบสดายด้วย NVHBM ย้ายตัวควบคุมหน่วยความจำ ซึ่งเป็นวงจรที่กำกับการไหลของข้อมูล จากหน่วยประมวลผลหลักไปไว้ที่ส่วนล่างสุดของชุดหน่วยความจำ ทำให้เบสดายกลายเป็นองค์ประกอบสำคัญยิ่งขึ้นของระบบประมวลผล แทนที่จะทำหน้าที่เพียงเชื่อมต่อหน่วยความจำกับหน่วยประมวลผล
สำหรับ Samsung การยอมรับสถาปัตยกรรมนี้หมายถึงการแยกการตัดสินใจสองเรื่องที่ก่อนหน้านี้ดำเนินควบคู่กัน ได้แก่ ใครเป็นผู้ผลิตหน่วยความจำสำหรับจัดเก็บข้อมูล และใครเป็นผู้ผลิตชิปตรรกะที่จัดการการเชื่อมต่อกับหน่วยประมวลผล Samsung จะยังคงจัดหาหน่วยความจำ ขณะที่ TSMC ผลิตเบสดายตามข้อกำหนด
เกิดอะไรขึ้นภายในชุดหน่วยความจำ?
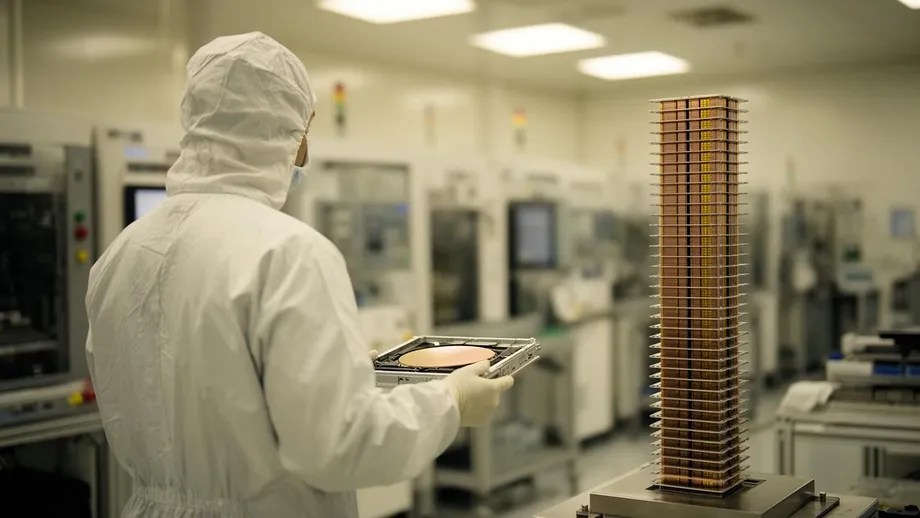
HBM นำดายหน่วยความจำหลายชิ้นมาวางซ้อนกันข้างหน่วยประมวลผลประสิทธิภาพสูง การออกแบบแบบซ้อนชั้นช่วยให้ข้อมูลปริมาณมากเดินทางได้ในระยะสั้น ทำให้ตัวเร่ง AI มีข้อมูลป้อนให้หน่วยประมวลผลอย่างต่อเนื่อง ดายคือชิ้นส่วนซิลิคอนแต่ละชิ้นที่มีวงจรอิเล็กทรอนิกส์อยู่ภายใน
ดายแกนกลางทำหน้าที่จัดเก็บข้อมูล ส่วนเบสดายที่อยู่ด้านล่างรองรับการเชื่อมต่อและการทำงานด้านตรรกะ ในการจัดวางแบบเดิม ตัวควบคุมหน่วยความจำจะอยู่บนดายตัวเร่งหลัก แต่ NVHBM ย้ายตัวควบคุมดังกล่าวไปไว้ในเบสดาย ทำให้มีพื้นที่บนหน่วยประมวลผลสำหรับวงจรอื่นมากขึ้น
Nvidia ยังใช้ส่วนเชื่อมต่อทางกายภาพแบบกำหนดเองที่เรียกว่า PHY เพื่อเชื่อมต่อชิปเข้าด้วยกัน PHY คือวงจรที่ส่งและรับสัญญาณไฟฟ้า คำอธิบายทางเทคนิคของ NVHBM ระบุว่า ระบบนี้ใช้การเชื่อมต่อแบบอนุกรมเฉพาะของบริษัท ซึ่งมีแบนด์วิดท์แคบกว่าและส่งข้อมูลผ่านจุดเชื่อมต่อน้อยจุดด้วยความเร็วสูง แทนอินเทอร์เฟซแบบขนานกว้างที่ใช้กับ HBM มาตรฐาน
ขนาดของอินเทอร์เฟซแบบเดิมช่วยให้เห็นเหตุผลที่แนวทางใหม่นี้น่าสนใจ HBM4 มี 32 แชนเนล แต่ละแชนเนลกว้าง 64 บิต รวมความกว้างทั้งหมด 2,048 บิต การจัดการจุดเชื่อมต่อเหล่านี้ต้องใช้วงจรจำนวนมากและการเดินสายที่ซับซ้อนระหว่างชิป NVHBM มีเป้าหมายลดภาระดังกล่าวและทำให้การกำหนดเส้นทางบนอินเตอร์โพเซอร์ ซึ่งเป็นชั้นเชื่อมต่อใต้ชิปง่ายขึ้น
Nvidia เสนอ NVHBM เป็นองค์ประกอบพื้นฐานสำหรับพันธมิตรด้านซิลิคอนแบบกำหนดเองผ่าน NVLink Fusion โดย HBM มาตรฐานยังคงเป็นผลิตภัณฑ์อีกประเภทหนึ่ง พันธมิตรที่เลือกใช้ NVHBM จะนำการออกแบบตัวควบคุมและการเชื่อมต่อตามข้อกำหนดของ Nvidia ไปใช้เป็นส่วนหนึ่งของระบบตัวเร่งประมวลผลของตน
เหตุใด Nvidia จึงต้องการกระบวนการเดียวกันจากทุกซัพพลายเออร์
สูตรการผลิตที่ Nvidia เสนอผสานกระบวนการตรรกะ 3 นาโนเมตรของ TSMC เข้ากับกระบวนการ DRAM ขั้นสูงสำหรับชั้นหน่วยความจำ วงจรตรรกะและ DRAM ทำหน้าที่ต่างกันและใช้วิธีการผลิตคนละแบบ ป้าย 3 นาโนเมตรระบุเทคโนโลยีการผลิตตรรกะรุ่นหนึ่ง ส่วน 1c ระบุเทคโนโลยี DRAM รุ่นหนึ่ง
Samsung, SK hynix และ Micron ต่างมีแบบออกแบบและวิธีการผลิตของตนเอง ความแตกต่างเหล่านี้อาจทำให้ต้องทดสอบเพิ่มเติม เมื่อนักพัฒนาตัวเร่งประมวลผลต้องการซื้อหน่วยความจำจากบริษัทมากกว่าหนึ่งแห่ง การใช้กระบวนการเดียวกันสำหรับเบสดายช่วยให้นักพัฒนามีจุดเริ่มต้นที่สอดคล้องกันมากขึ้น
การตรวจสอบยืนยันความเข้ากันได้ (validation) คือการตรวจว่าหน่วยประมวลผล หน่วยความจำ และแพ็กเกจทำงานร่วมกันได้ตามความเร็ว ระดับการใช้พลังงาน และความน่าเชื่อถือที่กำหนด การทำงานนี้ซ้ำสำหรับการออกแบบแต่ละแบบต้องใช้เวลาของทีมวิศวกรรม ข้อเสนอของ Nvidia มุ่งลดปริมาณงานบูรณาการแยกต่างหากที่ต้องทำเมื่อเปลี่ยนซัพพลายเออร์หน่วยความจำ
Micron เรียก DRAM รุ่นถัดไปของตนว่า 1-gamma ซึ่งโดยทั่วไปเทียบได้กับรุ่น 1c ตามคำศัพท์ที่ Samsung และ SK hynix ใช้ เป้าหมายร่วมจึงเป็นการนำเทคโนโลยีการผลิตต่างรุ่นที่แต่ละบริษัทเรียกชื่อต่างกันมารวมกัน ไม่ได้หมายความว่ากระบวนการผลิตหน่วยความจำของทุกซัพพลายเออร์จะเหมือนกันทั้งหมด
TSMC จะกลายเป็นพันธมิตรด้านการผลิตร่วมกันสำหรับผลิตภัณฑ์จากบริษัทหน่วยความจำที่แข่งขันกัน แนวทางนี้อาจช่วยให้ Nvidia นำระบบไปใช้กับซัพพลายเออร์แต่ละรายได้ง่ายขึ้น แต่ก็ทำให้ขั้นตอนการผลิตที่สำคัญขั้นหนึ่งกระจุกอยู่ที่โรงหล่อแห่งเดียว การที่ Samsung กำลังพิจารณาเส้นทางการผลิตสำรองสะท้อนให้เห็นความสำคัญในทางปฏิบัติของการจัดหาเบสดายให้เพียงพอ
Samsung ยังคงใช้โรงงานของตัวเอง
Samsung วางแผนรักษารูปแบบการผลิตแบบครบวงจรสำหรับ HBM มาตรฐาน ผลิตภัณฑ์ HBM4 และ HBM4E ของบริษัทใช้กระบวนการ 4 นาโนเมตรของ Samsung เองสำหรับเบสดาย และกระบวนการ 1c สำหรับดายแกนกลาง ชั้นหน่วยความจำผลิตที่โรงงานในฮวาซองและพยองแท็ก ประเทศเกาหลีใต้
Samsung เริ่มผลิต HBM4 ในปริมาณมากเมื่อต้นปี 2026 ขณะที่ HBM4E อยู่ระหว่างการทดสอบรับรองเพื่อผลิตในปริมาณมากในช่วงที่มีรายงานเมื่อเดือนตุลาคม การทดสอบรับรองคือขั้นตอนตรวจสอบว่าผลิตภัณฑ์พร้อมสำหรับการผลิตอย่างสม่ำเสมอตามมาตรฐานที่กำหนดหรือไม่
คาดว่า HBM แบบกำหนดเองสำหรับลูกค้ารายอื่น รวมถึง AMD จะยังคงใช้แนวทางการผลิตแบบครบวงจรของ Samsung ดังนั้นการตัดสินใจเรื่อง NVHBM จึงเป็นไปตามข้อกำหนดเฉพาะของ Nvidia ไม่ใช่การเปลี่ยนแนวทางทั้งบริษัทเพื่อเลิกผลิตเบสดายเอง
คาดว่าฝ่าย Memory Business ของ Samsung จะเป็นผู้นำด้านการออกแบบและการสนับสนุนการปรับแต่งเบสดายที่ผลิตโดย TSMC ซึ่งจะเปลี่ยนการแบ่งหน้าที่ภายใน Samsung โดยก่อนหน้านี้ฝ่าย System LSI และธุรกิจ Foundry มักมีส่วนร่วมในการผลิตเบสดายจากแหล่งภายใน
Samsung ยังประเมินด้วยว่าโรงหล่อของบริษัทเองจะสามารถผลิตเบสดาย NVHBM ได้หรือไม่ หากความต้องการสูงเกินกำลังการผลิตของ TSMC ทางเลือกสำรองที่เสนอนี้จะช่วยคงช่องทางการผลิตอีกทางไว้ แม้ว่าข้อกำหนดของ Nvidia ตามรายงานในปัจจุบันจะเน้นกระบวนการ 3 นาโนเมตรของ TSMC
Micron และ SK hynix เลือกแนวทางต่างกัน
การเปลี่ยนแปลงของ Micron ครอบคลุมมากกว่าผลิตภัณฑ์แบบกำหนดเองของ Nvidia บริษัทระบุว่าทั้ง NVHBM ซึ่งพัฒนาร่วมกับ Nvidia และ HBM4E มาตรฐาน จะใช้เบสดายที่ผลิตโดยโรงหล่อภายนอก คาดว่า TSMC จะรับหน้าที่ผลิต
สำหรับ HBM4 นั้น Micron ใช้ดายหน่วยความจำที่ผลิตด้วยกระบวนการ 1-beta ของบริษัทคู่กับเบสดายที่ผลิตภายในองค์กร ส่วน HBM4E เปลี่ยนชั้นหน่วยความจำไปใช้กระบวนการ 1-gamma และย้ายการผลิตเบสดายออกไปนอกโรงงานของ Micron ดังนั้น Micron จึงกำลังเปลี่ยนองค์ประกอบหลักทั้งสองส่วนของชุดหน่วยความจำ โดยใช้กระบวนการผลิตหน่วยความจำรุ่นใหม่ขึ้นพร้อมกับหันไปพึ่งพันธมิตรภายนอกในการผลิตชิปตรรกะ
Manish Bhatia ประธานเจ้าหน้าที่ฝ่ายปฏิบัติการของ Micron คาดว่า NVHBM จะมีราคาขายเฉลี่ยสูงขึ้นและทำกำไรได้มากขึ้น เหตุผลคือ HBM มีราคาขายแบบพรีเมียมอยู่แล้ว ขณะที่งานและฟังก์ชันเพิ่มเติมจากการปรับแต่งทำให้ผลิตภัณฑ์มีมูลค่าเพิ่ม การจ้างผลิตเบสดายจากภายนอกจึงสามารถเกิดขึ้นควบคู่กับการคาดการณ์ว่าจะทำกำไรได้มากขึ้น
ปัจจุบัน SK hynix ใช้กระบวนการผลิตตรรกะ 12 นาโนเมตรของ TSMC สำหรับเบสดาย HBM4 รายงานในอุตสาหกรรมระบุว่ากระบวนการ 3 นาโนเมตรของ TSMC กำลังได้รับการจัดลำดับความสำคัญสำหรับ HBM4E และ HBM แบบกำหนดเองในอนาคต ซึ่งจะนำการผลิตตรรกะที่ก้าวหน้าขึ้นมาใช้กับชิ้นส่วนที่รับผิดชอบมากกว่าเดิม
SK hynix ยังได้นำเสนอแนวคิด HBM แบบกำหนดเองที่ใช้เทคโนโลยี Stream DQ ในงาน GTC ของ Nvidia เมื่อต้นปี แนวคิดนี้มุ่งจัดการและป้อนข้อมูลให้หน่วยประมวลผลอย่างต่อเนื่อง สำหรับซัพพลายเออร์ทั้งสามราย ทิศทางร่วมกันคือทำให้เบสดายมีบทบาทเชิงรุกมากขึ้นในการเคลื่อนย้ายข้อมูล
ตัวเลขประสิทธิภาพของ Nvidia หมายถึงอะไร
Nvidia ระบุว่า NVHBM ให้แบนด์วิดท์ต่อชุดมากกว่า HBM4E มาตรฐานได้สูงสุด 30% และใช้พลังงาน HBM น้อยลง 15% แบนด์วิดท์วัดปริมาณข้อมูลที่เคลื่อนย้ายได้ในช่วงเวลาหนึ่ง แบนด์วิดท์ที่สูงขึ้นอาจช่วยหน่วยประมวลผล AI ที่ต้องรอข้อมูลจากหน่วยความจำ
หากเปรียบเทียบอย่างง่าย เมื่อชุด HBM4E มาตรฐานส่งข้อมูลได้ 100 หน่วยในช่วงเวลาหนึ่ง การปรับปรุงสูงสุดตามที่ Nvidia อ้างจะเพิ่มปริมาณดังกล่าวเป็น 130 หน่วย หากหน่วยความจำที่ใช้เปรียบเทียบกินไฟ 100 หน่วย การลดลงตามที่อ้างจะทำให้การใช้พลังงานของ HBM เหลือ 85 หน่วย ตัวอย่างเหล่านี้แสดงการคำนวณจากเปอร์เซ็นต์ ไม่ได้อธิบายถึงผลิตภัณฑ์ใดผลิตภัณฑ์หนึ่งที่วางจำหน่าย
Nvidia ยังระบุว่าสามารถเพิ่มพื้นที่ว่างบนดายประมวลผล XPU ได้สูงสุด 25% XPU เป็นคำกว้าง ๆ ที่ใช้เรียกหน่วยประมวลผล รวมถึงตัวเร่ง AI แบบกำหนดเอง การย้ายวงจรหน่วยความจำออกไปช่วยให้นักออกแบบจัดสรรพื้นที่ซิลิคอนส่วนดังกล่าวให้กับฟังก์ชันประมวลผลอื่นได้มากขึ้น
รายงานอีกฉบับเกี่ยวกับการนำเสนอของ Nvidia ระบุตัวเลขว่าดายหลักอาจมีสมรรถนะการประมวลผลเพิ่มขึ้นได้สูงสุด 30% ตัวเลขนี้วัดทรัพยากรการประมวลผลที่อาจเพิ่มขึ้น ส่วนตัวเลข 25% หมายถึงพื้นที่ซิลิคอนที่คืนมาได้จากการเปลี่ยนสถาปัตยกรรม ทั้งนี้ นักออกแบบยังต้องตัดสินใจว่าจะนำพื้นที่ที่ได้กลับมาไปใช้ทำอะไร
มีการระบุว่า PHY แบบกำหนดเองช่วยลดพื้นที่ที่อินเทอร์เฟซนี้ใช้ได้สูงสุด 67% โดยการประเมินทางเทคนิคคำนวณตัวเลขดังกล่าวจากจำนวนพินที่ลดลง การเปรียบเทียบโดยรวมด้านแบนด์วิดท์ พลังงาน และพื้นที่ของ Nvidia ใช้ HBM4E มาตรฐานเป็นเกณฑ์อ้างอิง ในช่วงที่ HBM4E ยังไม่เริ่มวางจำหน่าย
สำหรับบริการ AI การเคลื่อนย้ายข้อมูลที่เร็วขึ้นอาจช่วยให้สร้างคำตอบได้เร็วขึ้นเมื่อหน่วยความจำเป็นคอขวด การใช้พลังงานหน่วยความจำน้อยลงอาจเปิดโอกาสให้นักออกแบบระบบจัดสรรงบพลังงานได้มากขึ้น ผลกระทบต่อเซิร์ฟเวอร์ทั้งระบบยังขึ้นอยู่กับหน่วยประมวลผล ภาระงาน เครือข่าย และระบบระบายความร้อน ตลอดจนหน่วยความจำ
Amazon เชื่อมหน่วยความจำเข้ากับแพลตฟอร์มโดยรวมของ Nvidia
Annapurna Labs ของ Amazon เป็นพันธมิตร NVHBM รายแรกที่มีการประกาศ ธุรกิจออกแบบชิปแห่งนี้พัฒนาตัวเร่งประมวลผล Trainium สำหรับ Amazon Web Services ทำให้ Nvidia มีช่องทางจัดหาเทคโนโลยีหน่วยความจำให้บริษัทที่พัฒนาหน่วยประมวลผล AI ของตนเองด้วย
Nafea Bshara รองประธานของ Annapurna Labs กล่าวถึงจุดประสงค์ของความร่วมมือในความเห็นที่เผยแพร่พร้อมประกาศว่า:
เราตั้งตารอความร่วมมือด้านเทคโนโลยีนี้ เพื่อยกระดับการออกแบบโครงสร้างพื้นฐาน AWS ในอนาคต
คาดว่า Trainium 4 ของ Annapurna จะรองรับ NVLink Fusion รายงานเกี่ยวกับการเปิดตัว NVHBM ระบุว่าอาจเริ่มใช้งานพร้อมกับ Trainium 4 หรือในรุ่นถัดไป โดยยังไม่มีการยืนยันต่อสาธารณะว่าชิปของ Amazon รุ่นใดจะใช้ NVHBM และจะวางจำหน่ายเชิงพาณิชย์เมื่อใด
NVLink Fusion เปิดให้พันธมิตรเข้าถึงเทคโนโลยีต่าง ๆ ได้แก่ NVLink Chiplet, NVLink-C2C, NVLink Switch รวมถึงระบบและแร็ก MGX เทคโนโลยีเหล่านี้มีการเชื่อมต่อและการออกแบบระบบสำหรับนำหน่วยประมวลผลแบบกำหนดเองเข้ามาใช้ในโครงสร้างพื้นฐานด้านการประมวลผลของ Nvidia ส่วน NVHBM เพิ่มระบบย่อยหน่วยความจำเข้าไปในชุดเทคโนโลยีดังกล่าว
มีรายงานว่า MediaTek นำ NVLink Fusion มาใช้ห้าวันหลังการประกาศ NVHBM และวางแผนเสนอเทคโนโลยีนี้ให้ลูกค้า XPU ของตนด้วย ซึ่งเป็นอีกช่องทางที่ Nvidia จะเข้าถึงโครงการตัวเร่งประมวลผลแบบกำหนดเอง ตลาดนี้ยังมี Broadcom และ Marvell เป็นคู่แข่ง โดย Marvell เคยอธิบายแนวทางที่คล้ายกันในการย้ายการควบคุมหน่วยความจำเมื่อเดือนธันวาคม 2024 ทำให้การยอมรับจากลูกค้าและการบูรณาการระบบเป็นปัจจัยสำคัญในการแข่งขัน
พัฒนาการของการเปลี่ยนแปลง
การพัฒนา NVHBM ผสานการเปลี่ยนแปลงด้านสถาปัตยกรรม ความสัมพันธ์กับซัพพลายเออร์ และการนำไปใช้โดยลูกค้า ลำดับเหตุการณ์ช่วยอธิบายว่าทำไมการตัดสินใจของ Samsung ในเดือนตุลาคมจึงสำคัญ: Nvidia นำเสนอการออกแบบร่วมกันก่อน จากนั้นผู้ผลิตหน่วยความจำจึงต้องตัดสินใจว่าจะผลิตอย่างไร
- ธันวาคม 2024: Marvell ระบุแนวคิดที่คล้ายกัน โดยย้ายตำแหน่งของฟังก์ชันควบคุมหน่วยความจำในรูปแบบที่แตกต่างออกไป
- ช่วงต้นปี 2026: Samsung เริ่มผลิต HBM4 ในปริมาณมาก ขณะที่ SK hynix นำเสนอแนวคิด HBM แบบกำหนดเอง Stream DQ ในงาน GTC
- 26 สิงหาคม 2026: Nvidia ประกาศ NVHBM เป็นส่วนเสริมของ NVLink Fusion และระบุว่า Annapurna Labs เป็นพันธมิตรรายแรก
- ห้าวันต่อมา: มีรายงานว่า MediaTek นำ NVLink Fusion มาใช้ และวางแผนเปิดให้ลูกค้า XPU เข้าถึง
- 18 ตุลาคม 2026: รายงานในอุตสาหกรรมระบุว่า Nvidia ขอให้ใช้เบสดายจากกระบวนการ 3 นาโนเมตรของ TSMC และ Samsung ตอบรับหลังการทบทวนภายใน
การตัดสินใจของ Samsung ทำให้แผนการผลิตเข้าใกล้เป้าหมายของ Nvidia ที่ต้องการให้ซัพพลายเออร์หน่วยความจำทุกรายใช้การออกแบบที่สอดคล้องกันมากขึ้น ขณะเดียวกัน Samsung ยังคงลงทุนในเบสดายที่ผลิตเอง เพื่อรักษาทางเลือกที่แตกต่างสำหรับ HBM มาตรฐานและผลิตภัณฑ์แบบกำหนดเองที่จัดหาให้ลูกค้ารายอื่น
ประเด็นสำคัญ
- มีรายงานว่า Nvidia ต้องการให้ Samsung, SK hynix และ Micron ใช้กระบวนการ 3 นาโนเมตรของ TSMC สำหรับเบสดาย NVHBM
- NVHBM ย้ายตัวควบคุมหน่วยความจำจากหน่วยประมวลผลหลักไปไว้ในเบสดายของชุด HBM
- Samsung ตอบรับคำขอ แต่มีแผนคงการผลิต HBM มาตรฐานและผลิตภัณฑ์แบบกำหนดเองอื่น ๆ ไว้ภายในบริษัท
- Micron วางแผนผลิตเบสดายจากภายนอกทั้งสำหรับ NVHBM และ HBM4E มาตรฐาน ส่วน SK hynix ทำงานร่วมกับ TSMC สำหรับ HBM4 อยู่แล้ว
- Nvidia อ้างว่า NVHBM ให้แบนด์วิดท์เพิ่มขึ้นสูงสุด 30% และลดการใช้พลังงานของ HBM ลง 15% เมื่อเทียบกับ HBM4E มาตรฐาน
- Annapurna Labs ของ Amazon เป็นพันธมิตรรายแรกที่ประกาศ ขณะที่ Samsung กำลังประเมินว่าโรงหล่อของตนจะเป็นทางเลือกสำรองสำหรับการผลิตได้หรือไม่