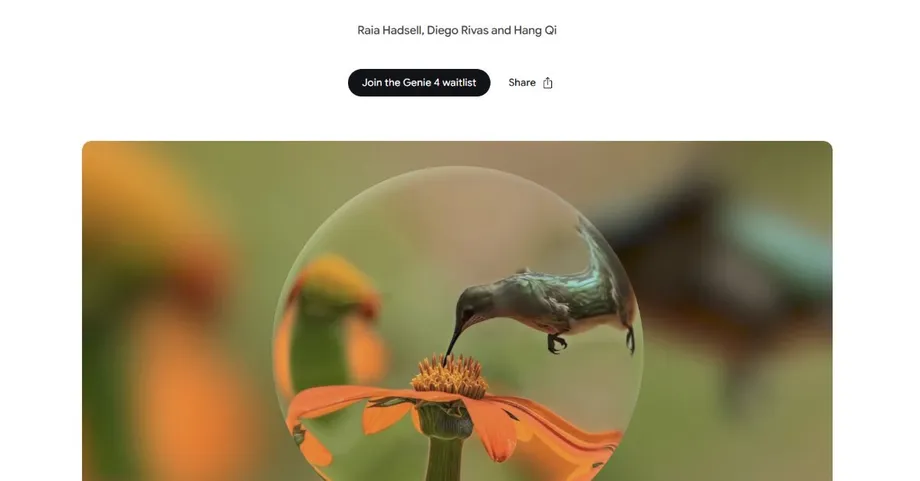
โลกเสมือนที่ตอบสนองด้วยภาพ การเคลื่อนไหว และเสียง
Google DeepMind เปิดตัว Genie 4 โมเดลปัญญาประดิษฐ์เชิงทดลองที่สร้างโลกเสมือนแบบโต้ตอบได้ พร้อมเสียง บทสนทนาที่พูดโต้ตอบได้ และสภาพแวดล้อมทางกายภาพที่เปลี่ยนแปลงไป โมเดลนี้ประกาศเปิดตัวเมื่อวันที่ 27 ตุลาคม ตามเวลาสหรัฐฯ และเปิดให้กลุ่มผู้ทดสอบที่ได้รับความไว้วางใจจำนวนเล็กน้อยใช้งานในระยะแรก โดยมีแผนเปิดให้เข้าถึงผ่าน Project Genie, Gemini API และ Google AI Studio
สารบัญ
- โลกเสมือนที่ตอบสนองด้วยภาพ การเคลื่อนไหว และเสียง
- โลกแบบโต้ตอบต่างจากวิดีโอที่สร้างขึ้นอย่างไร
- เสียงทำให้ตัวละครมีส่วนร่วมในการโต้ตอบ
- Gemini วางแผน ขณะที่ Genie สร้างโลก
- เหตุใด Google จึงต้องการให้หุ่นยนต์ฝึกในระบบนี้
- การวางแผนภาพยนตร์เป็นการใช้งานที่ใกล้ตัวกว่า
- ความต่อเนื่องสองนาทียังเป็นข้อจำกัดที่เข้มงวด
- ใครเข้าถึงได้ และมีค่าใช้จ่ายเท่าไร
- จาก Genie 3 สู่การแข่งขันที่กว้างขึ้นด้านการจำลอง
- ประเด็นสำคัญ
Google ระบุว่า Genie 4 รักษาความต่อเนื่องของฉากได้นานสูงสุดสองนาที นานกว่า Genie 3 รุ่นก่อนหน้าซึ่งทำได้ราวหนึ่งนาทีเป็นสองเท่า ในช่วงเวลาดังกล่าว ผู้ใช้สามารถเคลื่อนที่ไปในสภาพแวดล้อม เปลี่ยนสภาพอากาศ เพิ่มผู้คนหรือวัตถุ และได้ยินตัวละครตอบสนองต่อเหตุการณ์ที่เกิดขึ้น
Sundar Pichai ซีอีโอของ Alphabet และ Google กล่าวถึงโมเดลนี้ขณะประกาศเปิดให้ทดลองใช้เพื่อการวิจัยว่า:
โมเดลโลกที่สมจริงและโต้ตอบได้มากที่สุดของเรา
สิ่งที่เพิ่มเข้ามาสำคัญที่สุดคือเสียงในตัว หมายถึงระบบสร้างเสียงเป็นส่วนหนึ่งของประสบการณ์จำลอง ไม่ได้ใส่เพิ่มภายหลัง ทั้งเสียงลม คลื่น เพลงประกอบ และบทสนทนาสามารถเกิดขึ้นไปพร้อมกับการเปลี่ยนแปลงของโลกเสมือน Google ยังระบุว่ามีการปรับปรุงการเคลื่อนไหวของมนุษย์และการจำลองผลทางกายภาพ เช่น การชนและอากาศพลศาสตร์ หรือผลที่อากาศมีต่อวัตถุที่กำลังเคลื่อนที่
Google วางตำแหน่งเทคโนโลยีนี้ไว้สำหรับการวางแผนภาพยนตร์ การพัฒนาเกม การศึกษา และการฝึกหุ่นยนต์หรือเอเจนต์ AI ก่อนนำไปทำงานในสภาพแวดล้อมจริง ข้อจำกัดในระยะใกล้ก็เป็นเรื่องที่ใช้งานได้จริงไม่แพ้กัน ได้แก่ ฉากมีระยะเวลาเพียงสั้น ๆ วัตถุอาจเปลี่ยนแปลงโดยไม่คาดคิด ข้อความในฉากอาจอ่านยาก และความแม่นยำของเสียงยังเป็นปัญหาที่ต้องแก้ไข
โลกแบบโต้ตอบต่างจากวิดีโอที่สร้างขึ้นอย่างไร
Genie เริ่มจากคำบรรยายหรือภาพ แล้วสร้างสภาพแวดล้อมให้ผู้ใช้สำรวจ วิดีโอที่สร้างขึ้นทั่วไปดำเนินไปตามลำดับภาพที่ผู้ชมรับชม แต่โมเดลโลกจะสร้างสิ่งที่จะเกิดขึ้นต่อไป โดยตอบสนองต่อการกระทำของผู้ใช้
ผู้ใช้สามารถนำทางและกำหนดตำแหน่งกล้องด้วยแป้นพิมพ์ คำสั่งข้อความยังใช้เปลี่ยนสภาพแวดล้อมระหว่างที่ระบบทำงานได้ เช่น เปลี่ยนสภาพอากาศ เพิ่มตัวละคร หรือขยับมุมมอง จากนั้นระบบต้องสร้างภาพถัดไปให้สอดคล้องกับการเปลี่ยนแปลงเหล่านั้น
Google อธิบายว่าระบบสร้างประสบการณ์ทีละเฟรม แทนที่จะต้องเตรียมปฏิสัมพันธ์ที่เป็นไปได้ทั้งหมดไว้ล่วงหน้า โมเดลจะคาดการณ์ว่าฉากควรดำเนินต่อไปอย่างไรเมื่อมีคนลงมือทำบางอย่าง
ทำให้ความต่อเนื่องเป็นความท้าทายสำคัญ การจำลองที่มีประโยชน์ต้องจดจำตำแหน่งของวัตถุ การเคลื่อนไหวของผู้คน และสิ่งที่เกิดขึ้นไปแล้ว ฉากที่ดูน่าเชื่อถือชั่วขณะจะมีประโยชน์น้อยลง หากผังฉากเปลี่ยนไปเมื่อผู้ใช้หันกลับมา
เสียงทำให้ตัวละครมีส่วนร่วมในการโต้ตอบ
Genie 4 เพิ่มเสียงแวดล้อม เพลง และเสียงพูดเข้าไปในโลกภาพที่เปลี่ยนแปลงได้ Google ระบุว่าเสียงสามารถสอดคล้องกับสถานที่ที่ระบบสร้างขึ้น เช่น เสียงลมพัดผ่านต้นไม้หรือคลื่นซัดเข้าฝั่ง
ตัวละครยังพูดตอบสนองต่อคำสั่งของผู้ใช้และเหตุการณ์ภายในแบบจำลองได้ บทสนทนาของตัวละครมีจุดมุ่งหมายให้เปลี่ยนไปตามสถานการณ์ แทนการเล่นเสียงประกอบแบบตายตัว ผู้ใช้สามารถระบุองค์ประกอบด้านเสียงในคำสั่งได้เช่นเดียวกับองค์ประกอบด้านภาพ
Google ระบุว่ารูปร่างมนุษย์ได้รับการปรับปรุงในด้านอื่นด้วย โดยเคลื่อนไหวเป็นธรรมชาติมากขึ้นและตอบสนองต่อสภาพแวดล้อมได้ การกระทำของตัวละครสามารถถูกกำหนดได้ขณะที่การจำลองยังดำเนินต่อไป ทำให้พฤติกรรมตัวละครและการแก้ไขฉากรวมอยู่ในการโต้ตอบเดียวกัน
ทีมงานยอมรับว่าความแม่นยำของเสียงยังเป็นประเด็นที่ต้องพัฒนา สำหรับผู้ที่กำลังวางแผนฉากหรือกิจกรรมโต้ตอบ สิ่งสำคัญในทางปฏิบัติคือเสียงพูดและเสียงแวดล้อมต้องยังเหมาะสมเมื่อการกระทำเปลี่ยนไป
Gemini วางแผน ขณะที่ Genie สร้างโลก
Google ผสานโมเดล AI ตระกูล Gemini เข้ากับ Genie 4 อย่างใกล้ชิดยิ่งขึ้น โดยแต่ละโมเดลมีหน้าที่ต่างกัน: Genie สร้างโลกจำลอง ส่วน Gemini ช่วยกำกับสิ่งที่จะเกิดขึ้นและตรวจสอบว่าผลลัพธ์เป็นไปตามแผนที่ตั้งใจไว้หรือไม่
Gemini Omni รองรับการสร้างรูปลักษณ์และพฤติกรรมของสภาพแวดล้อม ส่วน Gemini 3.8 Flash จะตรวจสอบเฟรมที่เข้ามา แบ่งเป้าหมายออกเป็นขั้นตอนย่อย ตรวจสอบว่าการกระทำสำเร็จหรือไม่ และปรับแผนเมื่อฉากเปลี่ยนหรือผู้ใช้เข้ามาแทรกแซง
พูดง่าย ๆ คือส่วนหนึ่งของระบบสร้างภาพถัดไป ขณะที่อีกส่วนติดตามความคืบหน้าในการไปสู่เป้าหมาย การแบ่งหน้าที่เช่นนี้มีจุดมุ่งหมายเพื่อช่วยให้เหตุการณ์ดำเนินไปอย่างสมเหตุสมผล โดยเฉพาะเมื่อภารกิจต้องอาศัยการกระทำหลายขั้น แทนการตอบสนองทันทีเพียงครั้งเดียว
Tejas Kulkarni ผู้อำนวยการฝ่ายวิจัยของ Google อธิบายแนวคิดระยะยาวของบริษัทระหว่างการบรรยายสรุปว่า:
ในอนาคต เราจะเห็นโมเดลโลกแบบผสมผสานเหล่านี้มากขึ้น โดยผสาน Gemini ที่เขียนโค้ดและข้อความ เข้ากับ Genie ที่รับข้อมูลเหล่านั้นแบบเรียลไทม์และจำลองความเป็นจริงในระดับนามธรรมที่แตกต่างกัน
การผสานดังกล่าวจะทำให้ภาษา โค้ด และการจำลองภาพทำงานร่วมกันได้ Genie 4 ใช้การแบ่งหน้าที่ในลักษณะนี้แล้วในขอบเขตจำกัด โดย Gemini ช่วยกำกับโลกที่กำลังสร้างขึ้นขณะที่ผู้ใช้สำรวจ
เหตุใด Google จึงต้องการให้หุ่นยนต์ฝึกในระบบนี้
Google DeepMind กำลังทดสอบว่า Genie 4 จะใช้สร้างสภาพแวดล้อมฝึกหุ่นยนต์และเอเจนต์ AI ได้อย่างไร เอเจนต์คือซอฟต์แวร์ที่มุ่งทำเป้าหมายให้สำเร็จด้วยการเลือกการกระทำ ตรวจสอบผลลัพธ์ และตัดสินใจว่าจะทำอะไรต่อ
ในการทดลองที่เกี่ยวข้องกับ Gemini Robotics นั้น Gemini 4 Argon แบ่งงานออกเป็นขั้นตอน แล้วให้ Genie 4 จำลองแบบเรียลไทม์ เป้าหมายคือศึกษาว่าหุ่นยนต์อาจทำงานซับซ้อนให้สำเร็จได้อย่างไรก่อนจะลองทำในโลกจริง
Google ระบุว่าสภาพแวดล้อมเสมือนสามารถสร้างสถานการณ์ที่พบหรือจัดขึ้นได้ยากในความเป็นจริงขึ้นมาใหม่ นักพัฒนาสามารถเปลี่ยนเงื่อนไขและตรวจสอบการตอบสนองของเอเจนต์ โดยไม่ต้องสร้างพื้นที่ทดสอบทางกายภาพใหม่สำหรับทุกสถานการณ์
การปรับปรุงด้านการชนและอากาศพลศาสตร์ที่กล่าวอ้างมีความสำคัญเป็นพิเศษต่อการใช้งานนี้ การฝึกต้องอาศัยความสัมพันธ์ที่เชื่อถือได้ระหว่างการกระทำกับผลลัพธ์ เช่น วัตถุเคลื่อนที่อย่างไรหลังถูกสัมผัส หรือสภาพแวดล้อมตอบสนองต่อการเคลื่อนไหวอย่างไร Google ยอมรับว่าปฏิสัมพันธ์ทางกายภาพที่ซับซ้อนยังเป็นความท้าทายของโมเดล
การวางแผนภาพยนตร์เป็นการใช้งานที่ใกล้ตัวกว่า
ผู้ทดสอบที่ได้รับความไว้วางใจมองว่าการสร้างต้นแบบภาพยนตร์และการทำสตอรีบอร์ดอย่างรวดเร็วอาจเป็นการใช้งานที่เหมาะสม สตอรีบอร์ดเป็นการวางลำดับภาพก่อนถ่ายทำ Genie 4 อาจช่วยให้ทีมสร้างสรรค์สำรวจตำแหน่งกล้อง การกระทำของตัวละคร และการเปลี่ยนแปลงบรรยากาศได้ตั้งแต่แนวคิดยังอยู่ระหว่างการพัฒนา
Diego Rivas วิศวกรของ Google DeepMind อธิบายระหว่างการบรรยายสรุปต่อสื่อว่าเหตุใดการตอบสนองทันทีจึงอาจเป็นประโยชน์ในขั้นตอนนี้:
การทำงานแบบเรียลไทม์จะมีคุณค่ามากที่สุดในจุดที่การรักษาความต่อเนื่องของกระแสความคิดสร้างสรรค์เป็นประโยชน์อย่างยิ่ง
Rivas ยกการระดมความคิดและการทำสตอรีบอร์ดเป็นตัวอย่าง จุดเด่นในทางปฏิบัติคือความรวดเร็ว ผู้สร้างสรรค์สามารถเปลี่ยนฉากและสำรวจผลลัพธ์ได้โดยไม่ต้องหยุดเพื่อเตรียมลำดับภาพแยกสำหรับแต่ละรูปแบบ
Google ยังมี Veo ซึ่งสร้างคลิปวิดีโอพร้อมเสียงที่ซิงโครไนซ์จากคำสั่ง Rivas กล่าวถึงความเป็นไปได้ในอนาคตที่ Gemini Omni อาจช่วยเปลี่ยนต้นแบบให้เป็นผลงานสร้างสรรค์ พร้อมระบุว่าความสามารถเหล่านั้นยังต้องใช้เวลาอีกระยะ
เกมและการศึกษาแบบโต้ตอบเป็นการใช้งานอื่นที่มีการเสนอไว้ จุดร่วมคือฉากที่ตอบสนองต่อผู้เข้าร่วม แทนที่จะเป็นสื่อสำเร็จรูปที่เล่นเหมือนเดิมทุกครั้ง
ความต่อเนื่องสองนาทียังเป็นข้อจำกัดที่เข้มงวด
ระยะเวลาความต่อเนื่องที่รายงานของ Genie 4 ซึ่งอยู่ที่สองนาที ยาวเป็นสองเท่าของ Genie 3 ที่ทำได้ราวหนึ่งนาที ทำให้ผู้ใช้มีเวลาสำรวจแนวคิดมากขึ้น แต่ก็ยังจำกัดระยะเวลาของกิจกรรมที่ดำเนินต่อเนื่อง
Google ระบุว่าวัตถุและรายละเอียดภาพอาจค่อย ๆ เปลี่ยนไปเมื่อการจำลองดำเนินต่อ วัตถุอาจเปลี่ยนรูปลักษณ์หรือตำแหน่ง และระบบอาจจำไม่ได้ว่าฉากเริ่มต้นอย่างไร ดังนั้นการใช้งานต่อเนื่องเป็นเวลานานยังคงเป็นเรื่องยาก แม้ Gemini จะช่วยรักษาความต่อเนื่องก็ตาม
ข้อความที่สร้างขึ้นภายในโลกเสมือนอาจอ่านไม่ออกด้วย ซึ่งเป็นปัญหาที่เห็นได้ชัดสำหรับฉากที่มีป้าย คำแนะนำ หรือข้อความอื่นที่ผู้ใช้จำเป็นต้องอ่าน
Google ระบุว่า Genie 4 เป็นโมเดลทดลองระยะแรก และกำลังทำงานร่วมกับผู้ทดสอบจากหลากหลายสาขา Rivas กล่าวว่า บริษัทยังอยู่ระหว่างพิจารณารูปแบบประสบการณ์ผลิตภัณฑ์ฉบับสมบูรณ์ สำหรับตอนนี้ การใช้งานที่เหมาะสมคือการทดลองสั้น ๆ ขณะที่ความต่อเนื่องของภาพ พฤติกรรมทางกายภาพ และเสียงยังต้องพัฒนาต่อไป
ใครเข้าถึงได้ และมีค่าใช้จ่ายเท่าไร
การเปิดให้ทดลอง Genie 4 เพื่อการวิจัยเริ่มต้นกับผู้ทดสอบที่ได้รับความไว้วางใจ Google วางแผนขยายการเข้าถึงสำหรับผู้ใช้ทั่วไปผ่าน Project Genie สำหรับสมาชิก Google AI Ultra และเปิดให้นักพัฒนาเข้าถึงผ่านความร่วมมือในโครงการทดลองใช้ก่อนใครผ่าน Gemini API และ Google AI Studio
Google ระบุว่าการขยายการเข้าถึงจะเกิดขึ้นในเร็ว ๆ นี้ โดยคาดว่าจะทยอยเปิดให้ใช้งานในช่วงไม่กี่สัปดาห์ข้างหน้า แต่ยังไม่ได้กำหนดวันที่แน่นอน Project Genie กำลังเปิดรับลงทะเบียนเข้ารายชื่อรอ ส่วนการเข้าถึงผ่าน API จะช่วยให้นักพัฒนาเชื่อมต่อโมเดลเข้ากับซอฟต์แวร์ของตนเอง ขณะที่ AI Studio เป็นพื้นที่สำหรับทดลองใช้โมเดลของ Google
แพ็กเกจ Google AI Ultra เริ่มต้นที่ 100 ดอลลาร์ต่อเดือนตามข้อมูลที่บริษัทระบุ ส่วนราคาสำหรับนักพัฒนาที่ใช้ Genie 4 โดยเฉพาะยังไม่มีการประกาศ การเปิดให้ผู้ใช้ AI Pro และ AI Plus เข้าถึงเป็นประเด็นที่พูดถึงในฐานะการขยายบริการในอนาคตที่อาจเกิดขึ้น ไม่ใช่แผนเปิดตัวที่ยืนยันแล้ว
Google ระบุว่าวิดีโอและเสียงที่สร้างขึ้นจะมี SynthID ซึ่งเป็นลายน้ำดิจิทัลสำหรับระบุเนื้อหาที่สร้างโดย AI เครื่องหมายนี้มีจุดมุ่งหมายเพื่อช่วยระบุเนื้อหาที่ระบบผลิตขึ้น เมื่อประสบการณ์จำลองเหล่านี้เข้าถึงผู้ใช้จำนวนมากขึ้น
จาก Genie 3 สู่การแข่งขันที่กว้างขึ้นด้านการจำลอง
Genie 4 เป็นอีกก้าวหนึ่งในความพยายามทำให้โมเดลโลกของ Google เข้าถึงผู้ใช้ได้มากกว่าการสาธิตงานวิจัย:
- สิงหาคม 2025: Google DeepMind ประกาศเปิดตัว Genie 3
- มกราคม 2026: Google เริ่มทดสอบ Project Genie โดยใช้โมเดลดังกล่าว
- พฤษภาคม 2026: Google ประกาศผสานการทำงานกับ Street View
- 27 ตุลาคม ตามเวลาสหรัฐฯ: Google ประกาศเปิดตัว Genie 4 และเริ่มเปิดให้ทดลองใช้เพื่อการวิจัย
การแข่งขันยังขยายจากฉากโต้ตอบที่ไม่มีเสียงไปสู่รูปแบบอื่น ๆ ด้วย GWM Worlds 2 ของ Runway ซึ่งเปิดตัวสองสามเดือนก่อน Genie 4 ตอบสนองต่อการกระทำของผู้ใช้และสร้างเสียงได้
ความเคลื่อนไหวอื่นในอุตสาหกรรมสะท้อนความสนใจด้านการจำลอง ทั้งเพื่อพัฒนา AI และระบบทางกายภาพ Rivian เข้าซื้อ Third Dimension เพื่อนำความสามารถด้านการจำลองมาใช้กับงานทดสอบรถยนต์ ส่วนรายงานข่าวเกี่ยวกับการเข้าซื้อ World Labs ของ AMD และการเจรจาซื้อ Decart ของ Amazon ก็ทำให้เทคโนโลยีโมเดลโลกเป็นส่วนหนึ่งของกระแสการซื้อขายกิจการที่กว้างขึ้น อย่างไรก็ตาม การหารือของ Amazon ยังอยู่ในขั้นเจรจา
ผลงานล่าสุดของ Google ผสานการสร้างฉาก บทสนทนา และการวางแผนด้วย Gemini ไว้ในระบบทดลองเดียว ขั้นตอนที่เป็นรูปธรรมต่อไปคือการขยายการเข้าถึง ซึ่งจะเปิดโอกาสให้ผู้สร้างสรรค์และนักพัฒนาจำนวนมากขึ้นได้ทดสอบว่างานระยะสั้นแบบใดที่โมเดลทำได้อย่างน่าเชื่อถือ
ประเด็นสำคัญ
- Google DeepMind ประกาศเปิดตัว Genie 4 เมื่อวันที่ 27 ตุลาคม ตามเวลาสหรัฐฯ โดยเริ่มจากกลุ่มผู้ทดสอบที่ได้รับความไว้วางใจ
- โมเดลสร้างโลกแบบโต้ตอบได้ พร้อมเสียงแวดล้อม เพลง และบทสนทนาพูดโต้ตอบได้
- Google ระบุว่าฉากมีความต่อเนื่องได้นานสูงสุดสองนาที เป็นสองเท่าของ Genie 3 ที่ทำได้ราวหนึ่งนาที
- โมเดล Gemini ช่วยวางแผนการกระทำ ติดตามฉากที่สร้างขึ้น และปรับการจำลอง
- การใช้งานที่วางแผนไว้ ได้แก่ การทำสตอรีบอร์ดภาพยนตร์ เกม การศึกษา และการฝึกหุ่นยนต์
- วัตถุอาจเปลี่ยนแปลง ข้อความอาจอ่านไม่ออก และฟิสิกส์ซับซ้อนกับความแม่นยำของเสียงยังเป็นความท้าทายที่ต้องพัฒนา
- มีแผนเปิดให้เข้าถึงผ่าน Project Genie, Gemini API และ Google AI Studio แต่ยังไม่มีการประกาศกำหนดการขยายบริการหรือราคาสำหรับนักพัฒนาอย่างแน่นอน