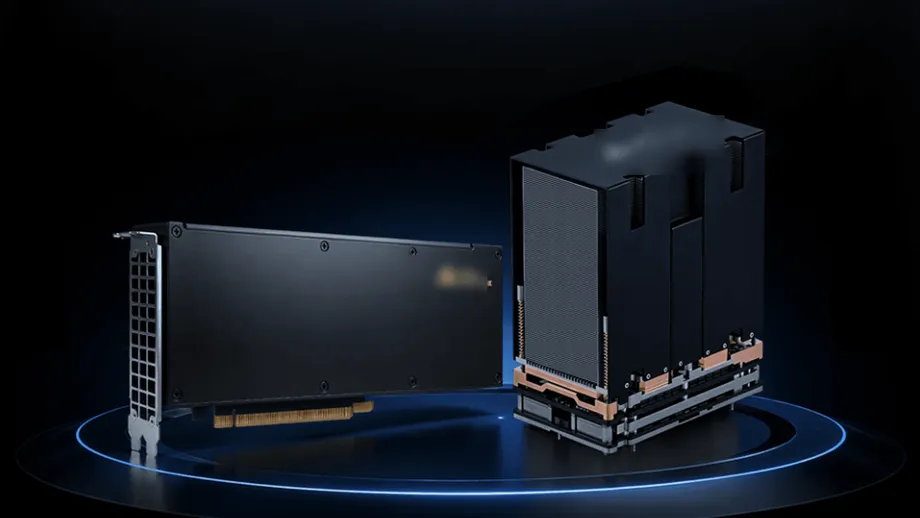
GPU ที่ใช้งานได้จริงกับคำกล่าวอ้างด้านปริมาณงานที่เพิ่มขึ้น 5%
Iluvatar CoreX สาธิตหน่วยประมวลผลกราฟิก Tiangai 300 ต่อสาธารณชนที่นครเซี่ยงไฮ้ โดยนำเสนอเป็นทางเลือกจากจีนแทน H200 ของ Nvidia พร้อมอ้างว่าทำผลงานได้เหนือกว่า 5% ในการทดสอบการอนุมานโดยบุคคลที่สาม ในงานเปิดบ้านสำหรับสื่อเมื่อวันที่ 28 ตุลาคม 2026 บริษัทยังจัดแสดงระบบฝึกโมเดลที่ใช้ GPU 8 ตัว และกล่าวถึงแร็กที่บรรจุ GPU 144 ตัวกับ CPU 18 ตัว
สารบัญ
- GPU ที่ใช้งานได้จริงกับคำกล่าวอ้างด้านปริมาณงานที่เพิ่มขึ้น 5%
- การเปรียบเทียบกับ H200 วัดอะไร
- เอกสารยาวขึ้น แต่ตอบสนองครั้งแรกเร็วขึ้น
- ผลการฝึกโมเดลใช้ Nvidia คนละรุ่นเป็นตัวอ้างอิง
- จากการเปิดตัวเดือนกรกฎาคมสู่การสาธิตเดือนตุลาคม
- แร็กที่ออกแบบมาสำหรับ GPU 144 ตัว
- แบ่งปันงาน AI ระหว่างชิปต่างประเภท
- คำกล่าวอ้างด้านซอฟต์แวร์มุ่งลดเวลาติดตั้งระบบ
- TY1200 ขยายข้อเสนอไปสู่หุ่นยนต์
- ประเด็นสำคัญ
การเปรียบเทียบที่เป็นประเด็นหลักมาจากการทดสอบที่ Shanghai Electric Group ดำเนินการในเดือนกรกฎาคม ตามข้อมูลของ Iluvatar CoreX ในการติดตั้งระบบที่แยกการประมวลผลโมเดลภาษาขนาดใหญ่ออกเป็นสองขั้น Tiangai 300 ทำปริมาณงานตั้งแต่ต้นจนจบได้เทียบเท่า 1.05 เท่าของ H200 หลังแปลงผลลัพธ์เป็นตัวเลขต่อการ์ดหนึ่งใบ
ปริมาณงานหมายถึงปริมาณงานที่มีประโยชน์ซึ่งระบบทำได้ในช่วงเวลาหนึ่ง สำหรับแชตบอต อาจหมายถึงจำนวนข้อความที่สร้างได้ในแต่ละวินาที ผลลัพธ์ที่ 1.05 เท่าของประสิทธิภาพอ้างอิงหมายถึงสร้างผลงานได้มากขึ้น 5% ภายใต้เงื่อนไขการทดสอบนั้น
บริษัทระบุว่า Tiangai 300 เป็น GPU อเนกประสงค์ของจีนรุ่นแรกที่ทำประสิทธิภาพได้ระดับ H200 ในการทดสอบที่วัดผลได้ การสาธิตในเดือนตุลาคมขยายการเปรียบเทียบไปยังโมเดลภาษา การสร้างภาพ และการสร้างวิดีโอ ขณะที่การสาธิตการฝึกโมเดลอีกชุดใช้ H100 ของ Nvidia เป็นตัวอ้างอิง
งานนี้นำเสนอมากกว่าข้อมูลจำเพาะของชิป Iluvatar CoreX จัดแสดงการ์ด เซิร์ฟเวอร์ การออกแบบแร็กความหนาแน่นสูง เครื่องมือซอฟต์แวร์ และวิธีแบ่งปันงาน AI ระหว่างโปรเซสเซอร์ต่างประเภทกัน ข้อเสนอทางธุรกิจของบริษัทคือองค์ประกอบเหล่านี้ช่วยสร้างผลงาน AI ที่ใช้งานได้ด้วยต้นทุนต่ำลงและใช้เวลารอน้อยลง
การเปรียบเทียบกับ H200 วัดอะไร
การทดสอบของ Shanghai Electric Group ในเดือนกรกฎาคมใช้วิธีแยกขั้น prefill และ decode ซึ่งมักเรียกย่อว่า PD separation ขั้น prefill คือช่วงที่โมเดลภาษาอ่านคำขอของผู้ใช้และข้อมูลประกอบ ส่วนขั้น decode คือช่วงที่โมเดลสร้างคำตอบทีละโทเคน โทเคนคือหน่วยย่อยที่ระบบ AI ใช้แบ่งข้อความ
การแยกขั้นเหล่านี้ทำให้ระบบจัดสรรทรัพยากรสำหรับการอ่านและการเขียนได้แตกต่างกัน ดังนั้นผลลัพธ์ของ Tiangai 300 จึงเป็นผลจากรูปแบบการติดตั้งระบบแบบหนึ่งโดยเฉพาะ โดยแสดงประสิทธิภาพรวมเป็นตัวเลขเทียบเท่าต่อการ์ดหนึ่งใบ
Iluvatar CoreX ยังไม่ได้เผยแพร่วิธีทดสอบโดยละเอียด รายชื่อโมเดล หรือเงื่อนไขของภาระงานที่อยู่เบื้องหลังผลทดสอบโดยบุคคลที่สามซึ่งเป็นประเด็นหลัก รายละเอียดเหล่านี้ รวมถึงวิธีคำนวณแปลงผลและการตั้งค่าซอฟต์แวร์ จำเป็นต่อการทำซ้ำผลทดสอบอย่างเป็นอิสระ นอกจากนี้ยังไม่มีการแจกแจงรายละเอียดต้นทุนที่ใช้เปรียบเทียบ ขณะที่ข้อมูลหน่วยความจำของการ์ดแต่ละใบและแร็กทั้งชุดก็ต้องการคำชี้แจงเพิ่มเติม
การสาธิตที่ระบุชื่อโดยห้องปฏิบัติการด้านประสิทธิภาพช่วยให้เห็นภาพคำกล่าวอ้างของบริษัทได้ละเอียดขึ้น โดยระบุผลปรับปรุงที่แตกต่างกันตามงาน ตั้งแต่การเพิ่มขึ้นเล็กน้อยในการสร้างสื่อหลายรูปแบบ ไปจนถึงการเพิ่มขึ้นมากกว่าในปริมาณงานระบบแนะนำ สำหรับผู้ซื้อ สิ่งที่ควรนำมาเปรียบเทียบคืองานที่บริการของตนใช้งานจริง
เอกสารยาวขึ้น แต่ตอบสนองครั้งแรกเร็วขึ้น
ห้องปฏิบัติการของบริษัทระบุว่า ประสิทธิภาพด้าน attention ของ Tiangai 300 ทำได้ 1.05 เท่าของ H200 เมื่อใช้ context length 64K Attention คือกระบวนการที่ช่วยให้โมเดลพิจารณาว่าส่วนใดของข้อมูลนำเข้ามีความเกี่ยวข้องกัน context length 64K หมายความว่าโมเดลกำลังจัดการโทเคนประมาณ 64,000 โทเคน
สำหรับ GLM-5.3 ที่ใช้บริบทขนาดเดียวกัน Iluvatar CoreX อ้างว่ามีปริมาณงาน 1.15 เท่าของ H200 โดยยังคงประสบการณ์ผู้ใช้เทียบเท่ากัน เท่ากับเพิ่มขึ้น 15% สำหรับภาระงานแบบ mixture of experts ที่นำมาทดสอบ โมเดล mixture of experts จะส่งงานไปยังเครือข่ายเฉพาะทางที่เลือกไว้ แทนที่จะใช้ทุกเครือข่ายกับทุกโทเคน
สำหรับภาระงาน AI agent ที่มีบริบทตั้งแต่ 8K ถึง 128K บริษัทระบุว่าลดเวลารอรับโทเคนเอาต์พุตแรกได้ประมาณ 10% ถึง 30% ตัวชี้วัดนี้สำคัญต่อผู้ที่รอให้ผู้ช่วยเริ่มตอบ หลังจากอ่านเอกสารยาวหรือประมวลผลคำขอที่ซับซ้อน
การสร้างภาพและวิดีโอเป็นอีกส่วนหนึ่งของการสาธิต บริษัทระบุว่าปริมาณงานด้านการสร้างสื่อหลายรูปแบบเพิ่มขึ้นประมาณ 2% ถึง 5% เมื่อเทียบกับ H200 สำหรับภาระงานค้นหาออนไลน์ โฆษณา และระบบแนะนำ บริษัทอ้างว่าปริมาณงานการอนุมานของระบบแนะนำเพิ่มขึ้น 21% และเวลาแฝงของการคำนวณแบบเบาลดลง 26%
ผลการฝึกโมเดลใช้ Nvidia คนละรุ่นเป็นตัวอ้างอิง
การสาธิตการฝึกโมเดลใช้ Qwen3-32B ซึ่งมีพารามิเตอร์ประมาณ 32,000 ล้านตัว บนเซิร์ฟเวอร์ GPU 8 ตัว พารามิเตอร์คือค่าตัวเลขที่โมเดลปรับระหว่างการฝึกเพื่อเรียนรู้รูปแบบ Iluvatar CoreX ระบุว่าปริมาณงานที่มีประสิทธิผลต่อการ์ดหนึ่งใบสูงถึง 1.33 เท่าของ H100 จาก Nvidia
ดังนั้น การสาธิตการฝึกโมเดลนี้มีประสิทธิภาพเหนือกว่า 33% โดยใช้ H100 เป็นชิปเปรียบเทียบ ส่วนผลการอนุมานในส่วนอื่นของงานใช้ H200 เป็นตัวอ้างอิง การแยกผลิตภัณฑ์อ้างอิงทั้งสองรุ่นออกจากกันเป็นสิ่งจำเป็นต่อการทำความเข้าใจตัวเลข
ระบบฝึกโมเดลทำงานที่ความละเอียด FP8 ซึ่งจัดเก็บตัวเลขด้วย 8 บิต ช่วยลดปริมาณข้อมูลที่ต้องเคลื่อนย้ายและประมวลผล เมื่อเทียบกับรูปแบบที่ใช้บิตมากกว่า ซอฟต์แวร์ฝึก AI ต้องจัดการความละเอียดที่ต่ำลงนี้อย่างระมัดระวังเพื่อรักษาคุณภาพการเรียนรู้
Iluvatar CoreX ยังรายงานว่าความแปรปรวนของเวลาในแต่ละสเต็ปอยู่ที่ 0.43% ระหว่างการทำงานต่อเนื่องที่โหลดเต็ม เทียบกับ 0.76% ของระบบอ้างอิงที่ใช้สถาปัตยกรรม Hopper เวลาในแต่ละสเต็ปคือเวลาที่ใช้ทำงานหนึ่งหน่วยซึ่งต้องทำซ้ำ การจับเวลาได้สม่ำเสมอขึ้นอาจช่วยให้ผู้ปฏิบัติงานวางแผนปริมาณงานที่ระบบซึ่งมีงานหนาแน่นจะทำได้
จากการเปิดตัวเดือนกรกฎาคมสู่การสาธิตเดือนตุลาคม
Tiangai 300 เปิดตัวอย่างเป็นทางการที่งาน World Artificial Intelligence Conference ในเดือนกรกฎาคม 2026 โดยใช้สถาปัตยกรรม Tianshu ของบริษัท ประกอบด้วย Tensor Core รุ่นใหม่ และมีข้อมูลจำเพาะด้านหน่วยความจำกราฟิก 144GB
โปรเซสเซอร์รองรับการประมวลผลแบบ scalar, vector และ tensor กล่าวอย่างง่ายคือ ใช้จัดการตัวเลขเดี่ยว กลุ่มตัวเลข และอาร์เรย์ทางคณิตศาสตร์ขนาดใหญ่ รูปแบบตัวเลขที่รองรับ ได้แก่ FP4, FP8, FP16 และ BF16 ซึ่งช่วยให้นักพัฒนาซอฟต์แวร์เลือกได้ตามความเร็ว การใช้หน่วยความจำ และความแม่นยำเชิงตัวเลข
หมุดหมายสำคัญที่บริษัทเปิดเผยต่อสาธารณะครอบคลุมระยะเวลาหลายเดือน:
- กรกฎาคม 2026: Tiangai 300 เปิดตัวที่งาน World Artificial Intelligence Conference
- กรกฎาคม 2026: Shanghai Electric Group ดำเนินการทดสอบโดยบุคคลที่สามซึ่งถูกอ้างถึงในการเปรียบเทียบปริมาณงานกับ H200 เสร็จสิ้น
- ก่อนงานสื่อเดือนตุลาคม: มีการจัดแสดงการออกแบบแร็ก IXL144 ที่งาน China International Industry Fair
- 28 ตุลาคม 2026: Iluvatar CoreX เปิดให้สื่อเข้าชมการสาธิตฮาร์ดแวร์ Tiangai 300 แบบสดที่เซี่ยงไฮ้
งานเดือนตุลาคมขยับการนำเสนอผลิตภัณฑ์จากการอธิบายสถาปัตยกรรมไปสู่ระบบที่รันภาระงานซึ่งระบุชื่อไว้ ช่วงการติดตั้งระบบที่บริษัทกล่าวถึงในขณะนี้ครอบคลุมตั้งแต่การ์ดเร่งความเร็วแต่ละใบ ไปจนถึงเซิร์ฟเวอร์ที่ใช้การ์ด 8 ใบ และระบบ IXL144 ขนาดใหญ่กว่า
แร็กที่ออกแบบมาสำหรับ GPU 144 ตัว
IXL144 รวม GPU 144 ตัวและ CPU 18 ตัวไว้ในแร็กมาตรฐานหนึ่งชุด โดยมีหน่วยความจำ GPU รวมประมาณ 10.1TB ตามข้อมูลของ Iluvatar CoreX บริษัทระบุว่าเป็นซูเปอร์โหนด GPU ที่มีความหนาแน่นสูงที่สุดในอุตสาหกรรมและติดตั้งอยู่ในแร็กเดียว ซูเปอร์โหนดเชื่อมต่อโปรเซสเซอร์จำนวนมากเข้าด้วยกันอย่างใกล้ชิด เพื่อให้ทำงานขนาดใหญ่ร่วมกันได้
ข้อมูลจำเพาะที่ระบุว่ามีหน่วยความจำ 144GB ต่อ Tiangai 300 หนึ่งตัว และหน่วยความจำรวมของแร็กที่ 10.1TB ต้องการรายละเอียดการจัดวางที่ชัดเจนยิ่งขึ้น เมื่อนำการ์ด 144 ใบคูณกับ 144GB จะได้ 20,736GB ก่อนคำนึงถึงความแตกต่างของวิธีนับความจุ รายละเอียดแร็กจึงควรระบุการจัดวางการ์ดและความจุหน่วยความจำที่ภาระงานเข้าถึงได้
Iluvatar CoreX ประเมินว่าระบบนี้ลดต้นทุนต่อโทเคนที่มีประสิทธิผลหนึ่งล้านโทเคนได้ประมาณ 40% เมื่อเทียบกับระบบระดับแนวหน้าจากต่างประเทศ โทเคนที่มีประสิทธิผลหมายถึงเอาต์พุตที่นับเป็นงานที่มีประโยชน์ สำหรับผู้ให้บริการ AI ตัวชี้วัดนี้เชื่อมโยงค่าใช้จ่ายด้านฮาร์ดแวร์กับปริมาณเอาต์พุตที่ใช้งานได้จริง
การลดลง 40% หมายถึงต้นทุน 60 หน่วยสำหรับงานที่ระบบอ้างอิงมีต้นทุน 100 หน่วย เงินที่ประหยัดได้จริงจะขึ้นอยู่กับราคาอุปกรณ์ การใช้พลังงาน ซอฟต์แวร์ ภาระงาน และความสม่ำเสมอในการใช้งาน GPU
บริษัทยังระบุเป้าหมายของเอ็นจินเชื่อมต่อแบบเพียร์ทูเพียร์รุ่นถัดไปว่า จะลดเวลาถ่ายโอนข้อมูลหนึ่งครั้งภายในโดเมนที่เชื่อมต่อจาก 3 ถึง 5 ไมโครวินาที เหลือ 1 ไมโครวินาที การสื่อสารที่เร็วขึ้นมีประโยชน์เมื่อ GPU แต่ละตัวเก็บข้อมูลคนละส่วนของโมเดลและต้องแลกเปลี่ยนข้อมูลซ้ำหลายครั้ง
แบ่งปันงาน AI ระหว่างชิปต่างประเภท
แนวทางติดตั้งระบบแบบ heterogeneous ของ Iluvatar CoreX มอบหมายส่วนต่างๆ ของการอนุมานให้โปรเซสเซอร์คนละประเภท ภายใต้รูปแบบแยกงาน AFD ของบริษัท Tiangai 300 จะจัดการขั้น prefill ทั้งหมดและการคำนวณ attention ระหว่างขั้น decode ส่วน XPU ของพันธมิตรจะจัดการเครือข่ายผู้เชี่ยวชาญแบบ feed forward
XPU เป็นคำเรียกกว้างๆ สำหรับตัวเร่งการประมวลผลอีกประเภทหนึ่ง แนวคิดคือมอบหมายงานให้โปรเซสเซอร์แต่ละตัวตามจุดแข็ง พร้อมใช้ตัวจัดตารางงานร่วมกันเพื่อประสานงานทั้งหมด เครือข่าย feed forward ทำหน้าที่ประมวลผลทางคณิตศาสตร์ส่วนสำคัญอีกส่วนหนึ่งภายในโมเดลภาษา
บริษัทระบุว่าการตั้งเวลาทำงานแบบรวมช่วยลดเวลาแฝงของการอนุมานในขั้น decode ได้ 60% การจัดวางระบบนี้แตกต่างจากการเปรียบเทียบปริมาณงานกับ H200 ซึ่งอ้างความได้เปรียบ 5% และใช้ตัวชี้วัดด้านประสิทธิภาพคนละแบบ
Shan Tianyi หัวหน้าฝ่าย AI และการประมวลผลแบบเร่งความเร็วของบริษัทกล่าวว่า ระบบประมวลผล AI ในอนาคตจะขึ้นอยู่กับการจัดการชิปต่างชนิดให้ทำงานได้อย่างมีประสิทธิภาพ มากกว่าการพึ่งพาโปรเซสเซอร์ชนิดเดียวสำหรับทุกงาน การสาธิต AFD แสดงให้เห็นกลยุทธ์ดังกล่าวผ่านการจัดวาง GPU และตัวเร่งความเร็วของพันธมิตรให้ทำงานร่วมกันอย่างเป็นรูปธรรม
คำกล่าวอ้างด้านซอฟต์แวร์มุ่งลดเวลาติดตั้งระบบ
Iluvatar CoreX ยังนำเสนอชุดซอฟต์แวร์ AI for AI ที่ออกแบบมาเพื่อทำงานบางส่วนของการติดตั้งและปรับแต่งระบบโดยอัตโนมัติ บริษัทระบุว่างานตั้งค่าสภาพแวดล้อมลดลงจากหนึ่งชั่วโมงเหลือ 10 นาที ขณะที่จำนวนการดำเนินการด้วยมือลดจากหลายสิบขั้นตอนเหลือหนึ่งขั้นตอน
สำหรับงานปรับแต่งโมเดลขนาดใหญ่หนึ่งงาน บริษัทระบุว่าลดระยะเวลาทำงานจากเจ็ดวันเหลือน้อยกว่าสองชั่วโมง พร้อมเพิ่มประสิทธิภาพจนเกือบสองเท่าของระดับก่อนหน้า ตัวอย่างเหล่านี้เกี่ยวข้องกับงานด้านวิศวกรรมที่จำเป็นต่อการทำให้โมเดลทำงานบนฮาร์ดแวร์ได้อย่างมีประสิทธิภาพ
บริษัทยังอ้างว่าผสานการทำงานกับ FlyDSL อย่างลึกซึ้ง ซึ่งเป็นภาษาที่ใช้พัฒนารูทีนการคำนวณบน GPU โดยระบุว่าความเร็วในการคอมไพล์เพิ่มขึ้นกว่า 90% และกล่าวถึงขั้นตอนการทำงานที่เดิมต้องใช้คน 10 คนทำงานหนึ่งวัน ซึ่งเปลี่ยนเป็นให้คนหนึ่งคนทำเสร็จได้ภายในไม่กี่ชั่วโมง
การรองรับด้านซอฟต์แวร์มีความสำคัญ เพราะโปรเซสเซอร์ต้องอาศัยมากกว่าฮาร์ดแวร์ที่คำนวณได้ดี โมเดล ไลบรารีคณิตศาสตร์ และเครื่องมือติดตั้งระบบต้องทำงานร่วมกันได้ การสาธิตซอฟต์แวร์ชี้ให้เห็นว่าลูกค้าอาจต้องใช้ความพยายามด้านวิศวกรรมมากเพียงใด ก่อนเปลี่ยน GPU รุ่นใหม่ให้เป็นบริการที่ใช้งานได้
TY1200 ขยายข้อเสนอไปสู่หุ่นยนต์
ภายในงานที่เซี่ยงไฮ้ยังมี Tongyang TY1200 โปรเซสเซอร์อีกตัวที่มุ่งเป้าไปยัง AI PC และปัญญาประดิษฐ์เชิงกายภาพ รวมถึงหุ่นยนต์ที่รับรู้และลงมือทำในโลกจริง โดยระบุสมรรถนะการประมวลผลแบบ dense ที่ 300 TOPS หรือ 300 ล้านล้านการดำเนินการต่อวินาที การประมวลผลแบบ dense นับงานโดยไม่อาศัยการข้ามการคำนวณที่เกี่ยวข้องกับค่าศูนย์
Iluvatar CoreX อ้างว่า TY1200 ทำผลงานได้ 1.2 เท่าของ Nvidia Thor T5000 ในการทดสอบกับ Qwen3.8-27B และ Qwen3.6-35B-A3B สำหรับโมเดล Cosmos-R2-2B และ Cosmos-R2-8B ในสถานการณ์ AI เชิงกายภาพ บริษัทระบุว่าทำประสิทธิภาพได้เทียบเท่า 158% และ 180% ของผลอ้างอิงจาก Thor T5000 ตามลำดับ
บริษัทยังระบุว่า TY1200 สามารถจำลองฟิสิกส์โดยเร่งความเร็วด้วย GPU ผ่าน MuJoCo-Warp ได้ ทำให้ระบบพัฒนาหุ่นยนต์จำลองการเคลื่อนไหว ฝึกนโยบายควบคุม และตรวจสอบการทำงานได้ในเครื่อง นโยบายควบคุมคือชุดคำสั่งที่เรียนรู้มา ซึ่งหุ่นยนต์ใช้ตัดสินใจว่าจะเคลื่อนไหวอย่างไร
การใช้งานที่บริษัทรายงานรวมถึงหุ่นยนต์ช่วยเหลือผู้คนระหว่างเข้ารับบริการทางการแพทย์ ระบบวิชันในภาคอุตสาหกรรม และการแนะนำผู้มาเยือน ส่วนรุ่นต่อยอดที่วางแผนไว้คือ TY2000 ซึ่งมีเป้าหมายด้านการประมวลผลที่ระบุไว้ 600T ผลิตภัณฑ์ทั้งสองขยายกลยุทธ์ของบริษัทจากเซิร์ฟเวอร์ AI ขนาดใหญ่ไปสู่อุปกรณ์ที่ทำงานใกล้ผู้ใช้และเครื่องจักร
ประเด็นสำคัญ
- Iluvatar CoreX สาธิตฮาร์ดแวร์ Tiangai 300 ที่เซี่ยงไฮ้เมื่อวันที่ 28 ตุลาคม 2026
- บริษัทอ้างผลการทดสอบของ Shanghai Electric Group ว่าปริมาณงานต่อการ์ดหนึ่งใบเทียบเท่า 1.05 เท่าของ Nvidia H200
- การสาธิตฝึก Qwen3-32B ด้วย GPU 8 ตัวรายงานว่าทำปริมาณงานต่อการ์ดได้ 1.33 เท่าของ H100 ที่ความละเอียด FP8
- ยังไม่มีการเผยแพร่วิธีการโดยละเอียดที่อยู่เบื้องหลังผลทดสอบอ้างอิงโดยบุคคลที่สามซึ่งเป็นประเด็นหลัก
- แร็ก IXL144 มี GPU 144 ตัวและ CPU 18 ตัว พร้อมอ้างว่าลดต้นทุนต่อโทเคนที่มีประสิทธิผลหนึ่งล้านโทเคนได้ 40%
- การติดตั้งระบบอีกรูปแบบหนึ่งที่แบ่งปันงานระหว่าง GPU และ XPU รายงานว่าลดเวลาแฝงในขั้น decode ได้ 60%
- งานนี้ยังครอบคลุมระบบอัตโนมัติด้านซอฟต์แวร์ และการใช้งาน TY1200 ใน AI ภายในเครื่องกับการจำลองหุ่นยนต์